机器人训练最缺的往往不是算法,而是环境。真实场地有限、采集成本高、场景还不能随便改。大晓机器人联合南洋理工大学 SLab 给出的解法,是一个名为 Mundo 的世界模型,近日正式发布。
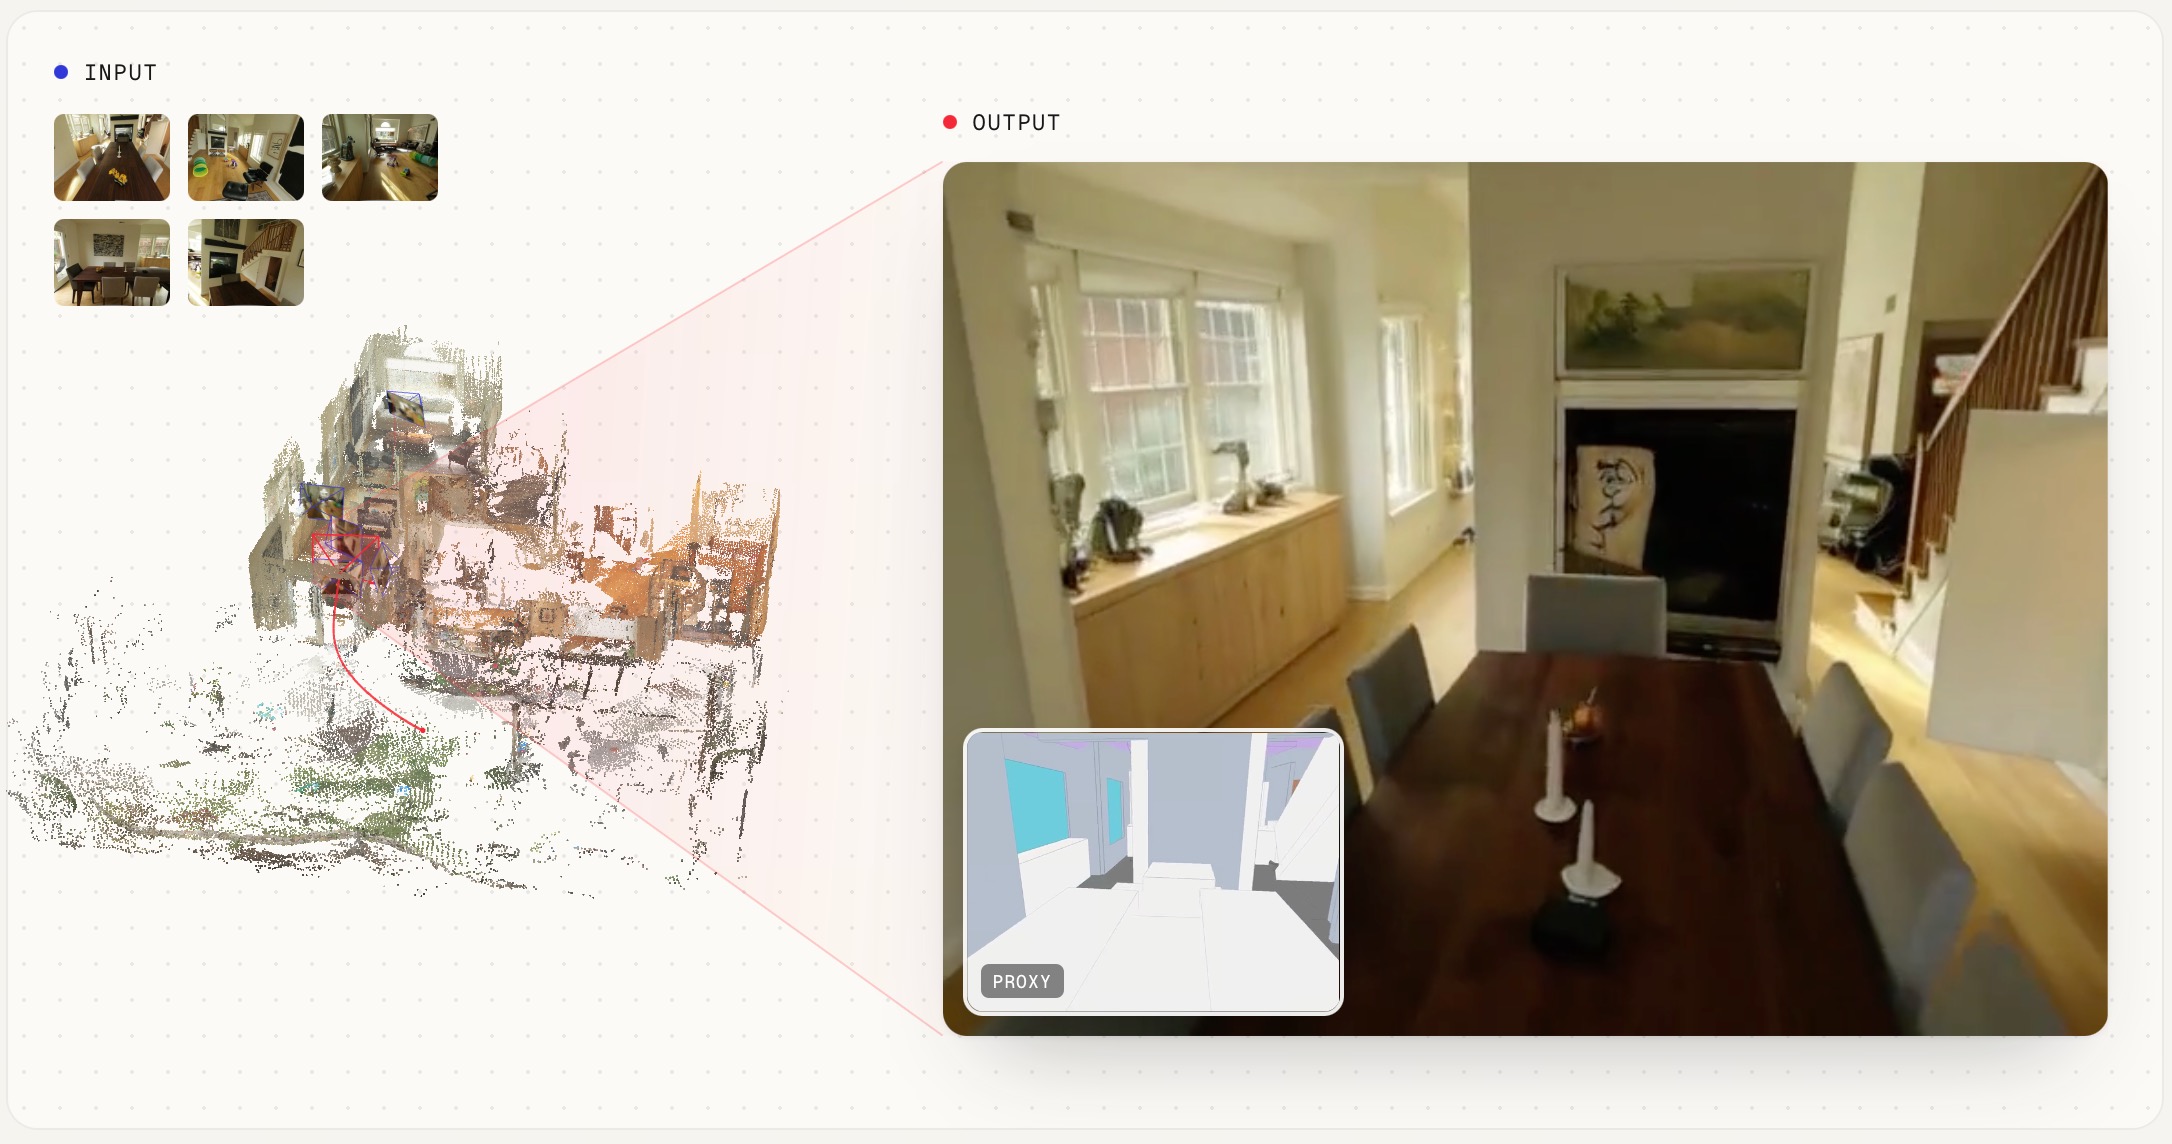
从能力上看,Mundo 的能力覆盖场景重建、自由视角探索与时空模拟。差别在于它对物理的处理:物体的质量、摩擦系数等属性被写进场景程序,运动、接触与碰撞交给物理引擎计算,而不是仅靠画面生成糊过去。
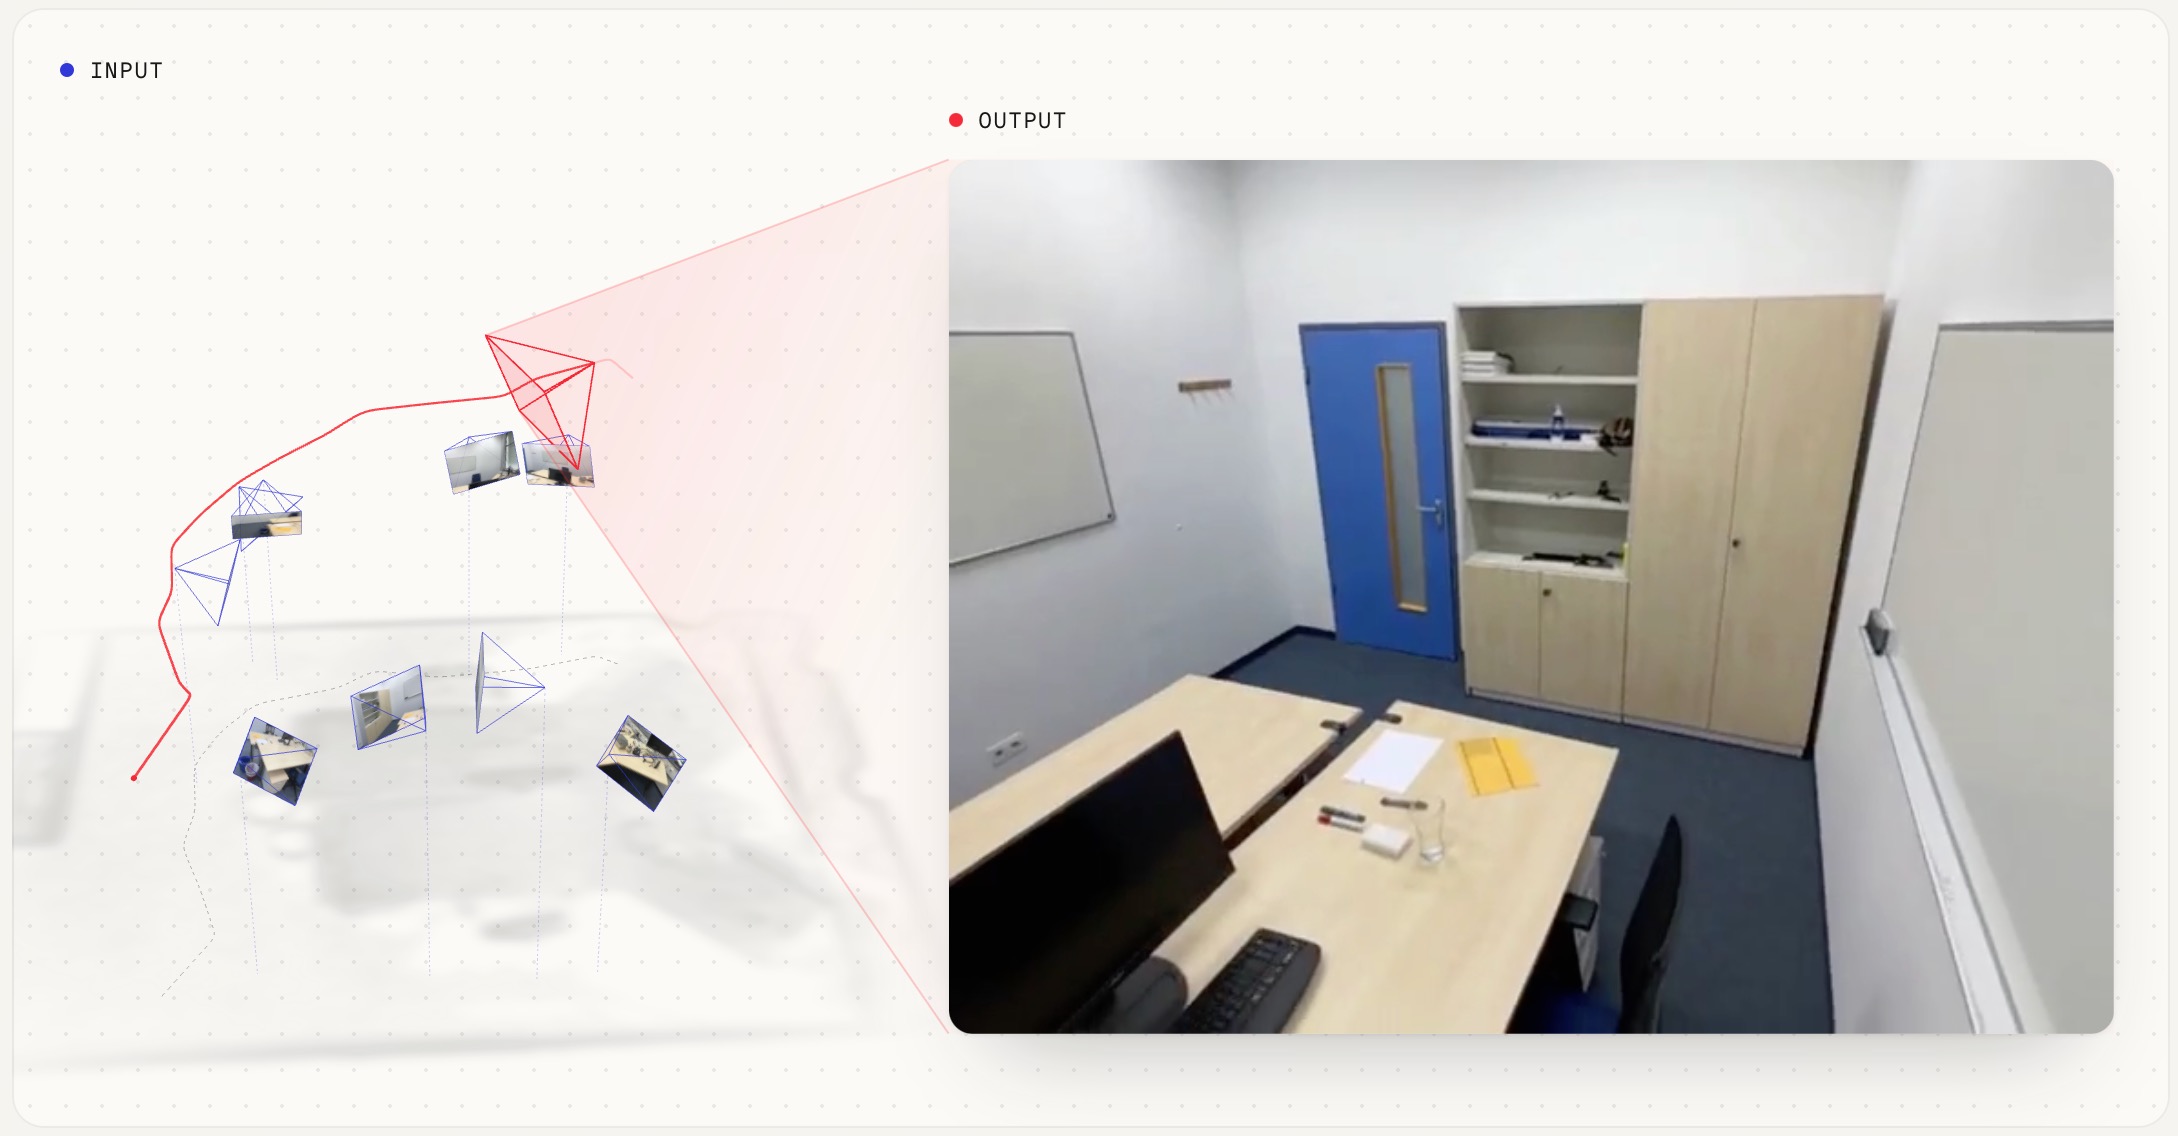
整个流程分三段。先由三维检测器先给主要物体定出初始位置和范围,再由视觉语言模型智能体在此基础上调整代理场景,通过渲染、比较、修正,让结构与输入影像对应;随后用户可以用代码编辑物体、属性与动作;最后由视频模型则参考实拍影像渲染,把变化呈现出来。几何、物理与外观各管一段,互不越界。
输入的起点很低。一到十二张图像,就能围绕房间里的家具与空间结构展开探索,同一组参考图像可以服务多条相机路径,观察位置和角度自由变化。一间办公室能从桌边绕到窗边,一处住宅能从庭院走进室内;没被拍到的区域由模型推断补全,参考视图越多,补全的不确定性越小。
大场景另有一套办法。面对数十张上下文图像,Mundo 会沿同一个三维代理分段生成,为每段挑选相关参考视图,再用重叠帧衔接前后片段,从而支撑数十秒至分钟级的长路径探索。局部外观与全局空间因此有了共同依据。
真正让它区别于"能看的模型"的,是交互。抽屉拉开、椅子推动、物体落地地,都需要相应的位置变化与接触关系。Mundo 用场景程序描述物体名称、尺寸与位姿,配置质量与摩擦,脚本定义动作与施加的力,物理引擎算出轨迹、接触点与碰撞力,再渲染回场景。垃圾桶可以拖、显示器可以推、椅子可以拉,也能改材料与重力条件看响应。
在同一个定制场景里,导航与操作被接通。三维代理给出物体类别、位置、障碍物与可通行区域,路径规划器据此找路,模型生成第一人称与第三人称画面;操作侧则为交互物体建立几何与物理属性,同一任务可由不同形态的机器人尝试,例如把苹果放进碗里、把罐子放上托盘。系统会保留任务轨迹与物理状态,供训练数据生成与仿真测试使用。
时间维度也被纳入。多相机记录的动态事件可以从新视角重现,选定时刻暂停再移动相机,就能得到类似子弹时间的多角度观察,便于查看遮挡关系与动作细节。在酒店场景中,团队已用它把楼层和洗衣区重建出来,为导航提供空间与语义信息,并模拟洗衣机开门这类交互。
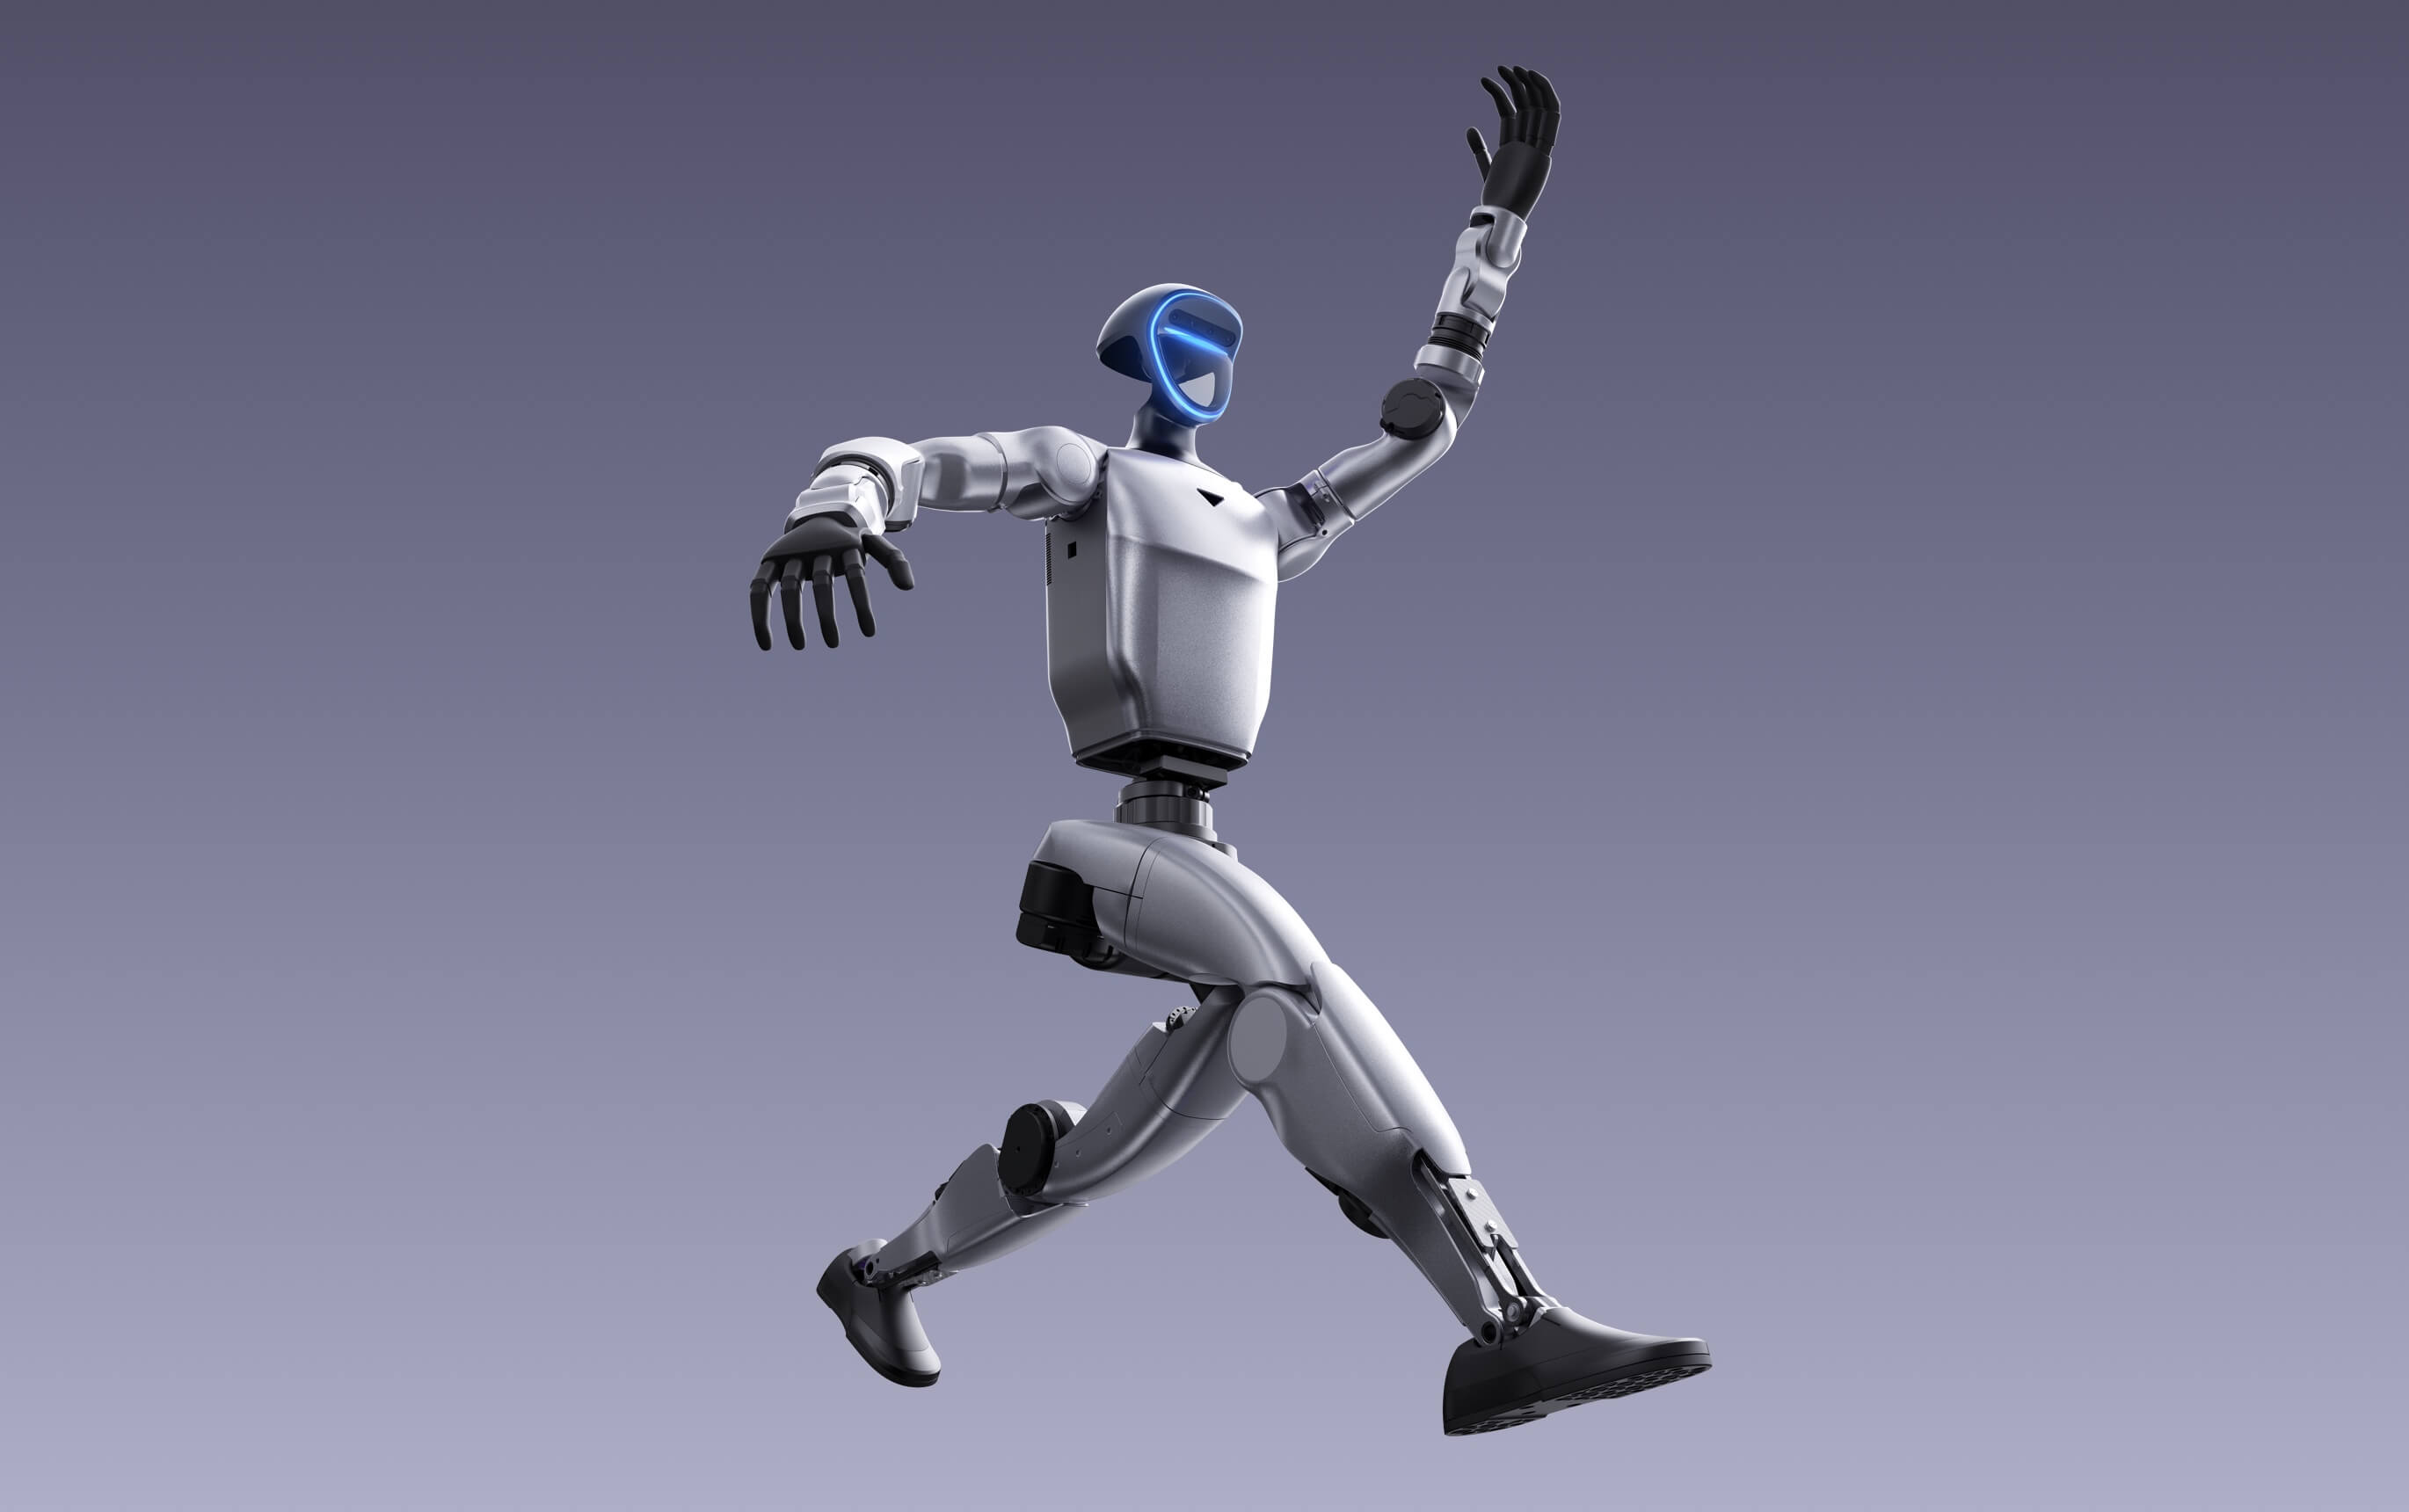
放到大晓的技术体系里看,Mundo 补的是环境建模与仿真训练这一环。公司以 Kairos 世界模型为核心,Mundo 负责把现场影像变成可进入、可操作的任务环境,再连接数据生成与策略优化。这条链条能否跑通,决定了机器人从演示走向实际工作场景的速度。
公司背景也值得一提。大晓机器人董事长由商汤的联合创始人、执行董事王晓刚担任,首席科学家是 AI 科学家陶大程院士,此前已开源并商用了开悟世界模型 3.1,同时推出面向酒店服务、零售、巡检的行业方案。Mundo 的出现,让这套 "环境式采集—世界模型—具身模组" 的叙事更完整了一些。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复