大模型的下一个战场,正在从"能不能答"转向"能不能做完一件事"。十一月二日,美团 LongCat 团队把新一代模型放了出来:LongCat 2.5,原生多模态,主打长程智能体任务。 2.5,把视觉理解与智能体编程捆在同一套架构里。
参数规模是 1.6 万亿,但每个 Token 只激活约 480 亿参数。这种稀疏设计的目的很明确:用更大的总容量承载知识,用更小的激活量控制推理成本。相比上一代 LongCat 2.0,这一代的重点落在原生视觉理解与智能体编程两处。
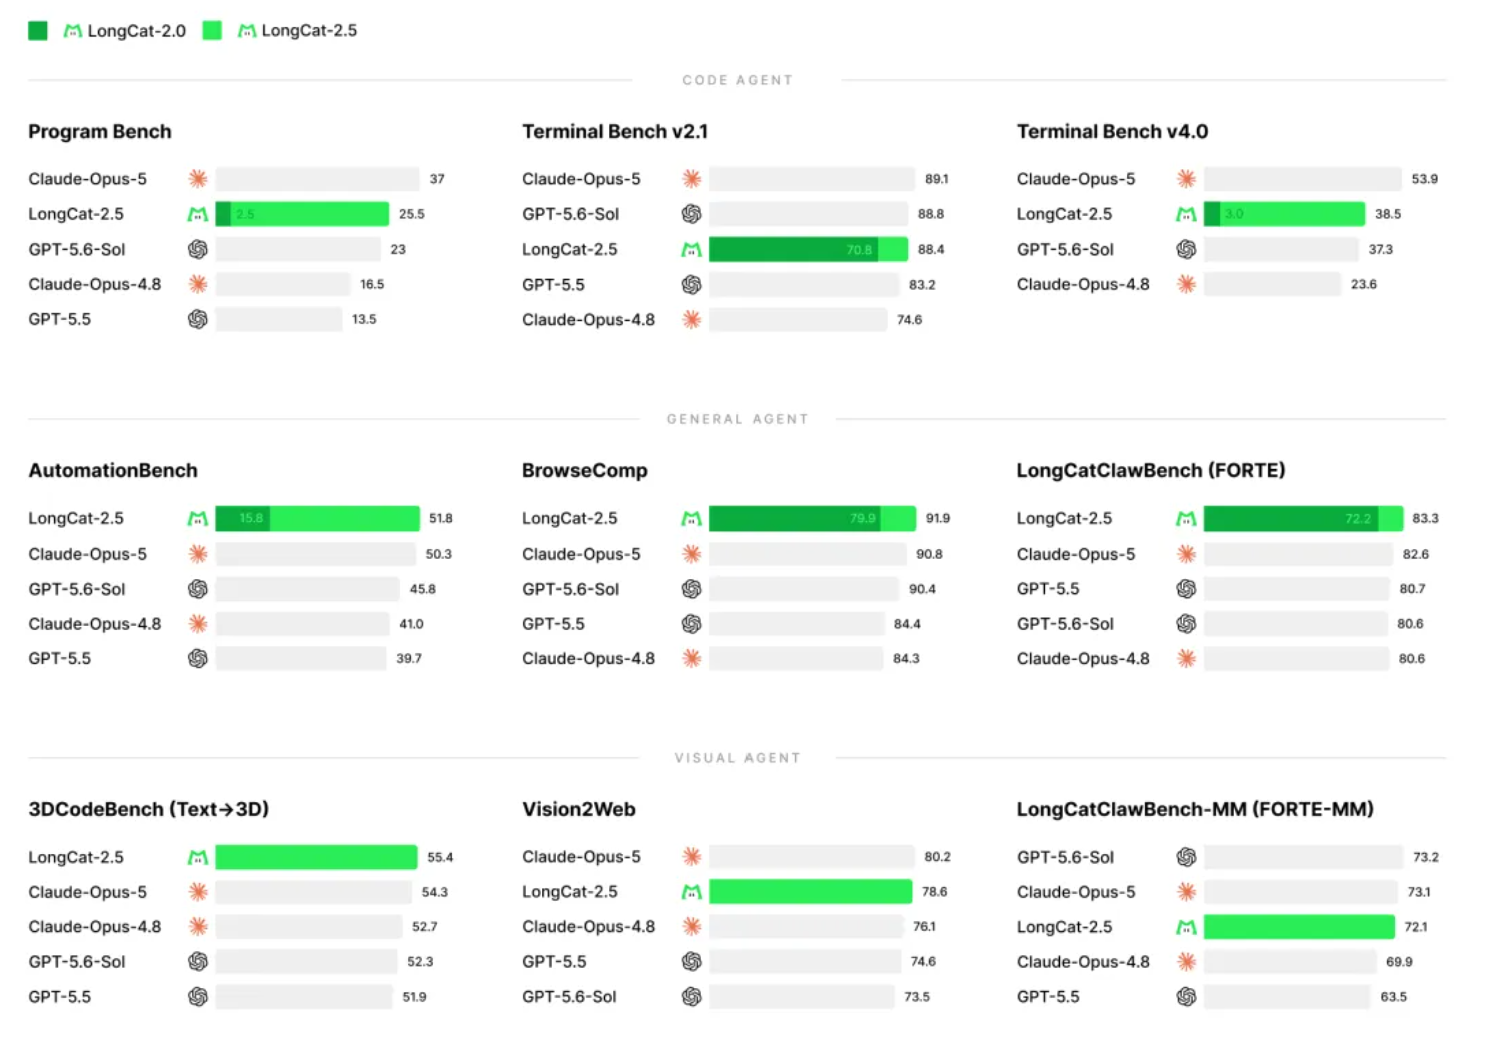
测评结果给出了一个参照系。美团自己做的那套自动化任务基准 AutomationBench、通用 Agent 基准 LongCatClawBench 上 上,LongCat 2.5 均领先 Claude Opus 5 与 GPT 5.6 Sol;到了终端操作评测 Terminal Bench v4.0,它拿到 38.5 分,超过 GPT 5.6 Sol,可还是落后于 Claude Opus 5。强项在任务编排,弱项在纯终端操作,这个画像比较清晰。
视觉的处理方式值得单独说。LongCat 2.5 把不同分辨率的图像编码成离散 Token 序列,与文本 Token 一起送进同一条主干,而不是外挂一个视觉编码器做特征拼接。编码环节沿用 LongCat Next 的方法:语义对齐编码器生成原生分辨率特征,残差向量量化把视觉信息压成多层级词表 Token,以缓解离散化过程中的信息损失。
训练侧还加了离线视觉 Token 预处理:固定 tokenizer 提前算好并缓存视觉 Token 编号,主干直接读取预处理后的序列,长序列打包与切分因此简化,分布式训练时各任务间的负载也更均衡。团队称,视觉码本嵌入与主干采用联合学习,在激活参数三十亿左右的小型 MoE 上,两类嵌入在可视化结果中已呈交织分布,说明信号开始在共享语义空间中融合。
长程任务是这一代的训练重心。团队从 GitHub 公开仓库与内部场景取代码任务,对筛过的 PR 与关联 issue 自动搭出可交互环境与可验证的测试用例,用 失败转通过 与 通过保持通过 测试校验任务有效性;训练中再用实时轨迹与通过率做二次标注,并基于假阴性、假阳性分析扩充测试集。
工程侧的难题在国产加速器。单卡显存不足 80GB,团队围绕超节点重排了 FSDP、EP、CP 三种并行度,叠加混合词表并行、动态专家复制与双重分片 FSDP,还把视觉编码整体移出训练计算图。按官方说法,这套配置在长序列监督微调任务中的单卡吞吐量,较 DDP 基线提升 86%。
实测部分比较直观。让模型做一段鹈鹕骑自行车的 HTML 动画,完成度较高,主体突出、风格统一,只是围巾位置略有偏差;让它解读亚马逊第三季度财报并生成带图表的 PPT,分析框架完整,趋势图、结构图与风险提示搭配自然,比对后未发现数据错误,但部分页面信息密度偏高、字号偏小,个别结论下得偏绝对。
从技术路线看,这一代的升级重点已不是单纯堆参数,而是视觉统一建模、长程智能体训练、训推一致性与国产算力适配这些系统工程。多模态模型正从"看懂内容"走向"完成任务",而能否在复杂代码库、3D 页面生成和多轮工具调用中持续执行并自我修正,会是下一阶段的真正分水岭。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复