GPU 采购成本高、供给紧的当下,AI 推理的比拼正在换赛道:从谁能买到最强的卡,转向谁把手里现有的算力用得更值。这家名叫是石科技、英文名 METASTONE 的公司,给出的思路是用纯软件优化去弥补硬件与框架之间的性能鸿沟。
它把自己定位为独立第三方全栈算力运营商,不绑定特定大模型厂商,提供从硬件、组网、调度到优化的全栈交付。按照披露,其纳管的算力资源已超过 20000P,运营 10 多个智算中心,另有 2 个国家级超算中心,集群安全稳定运行达到 99.95% 以上的服务水平承诺,团队曾获 3 项戈登·贝尔奖。其自研的 Meta Infer 推理引擎,瞄准的正是大量能跑起来、但跑不快的加速卡。
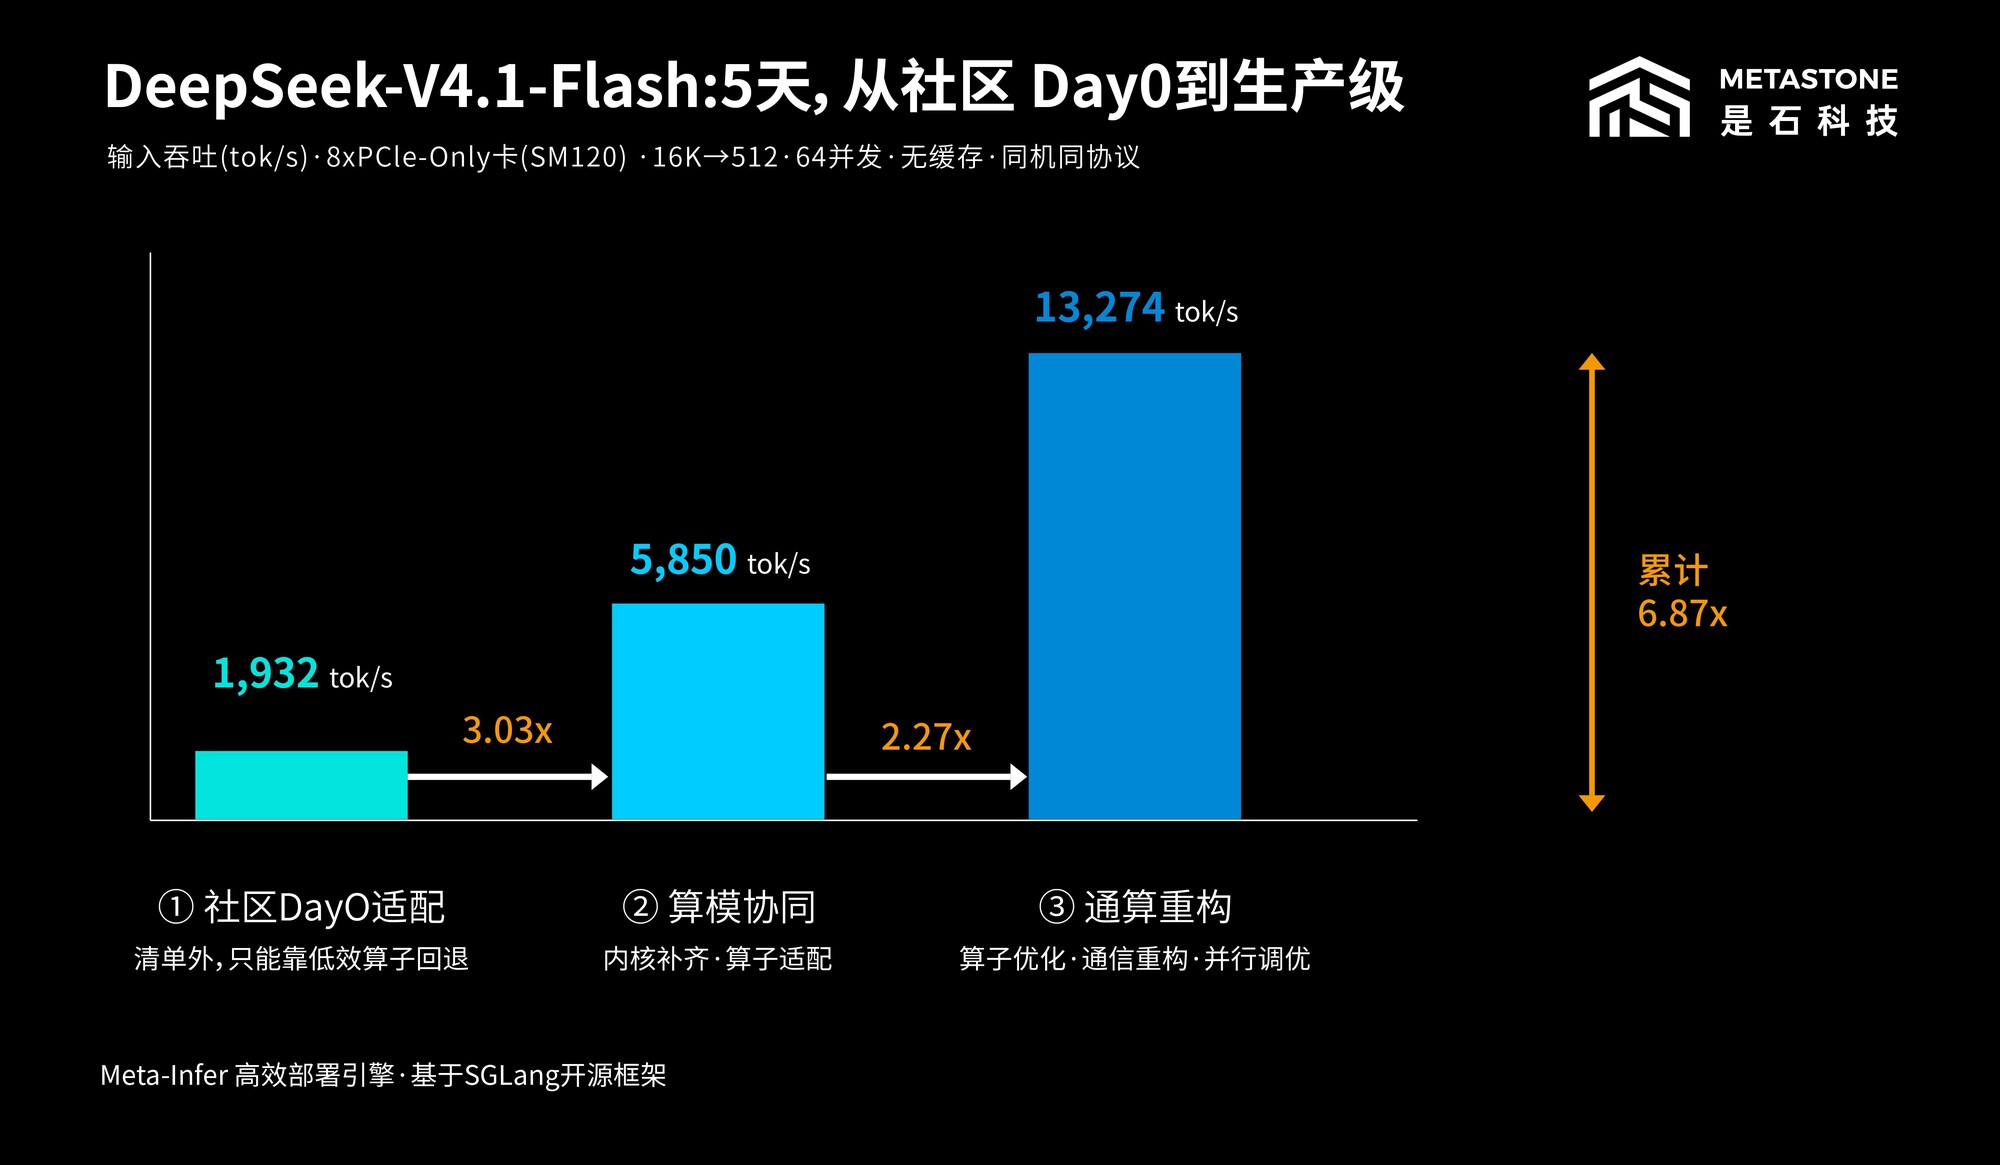
在很多开源框架里,不在官方验证清单上的硬件不会报错,而是被静默绕开加速路径,退回到低效的通用实现;集合通信也可能沿用为高速互联硬件准备的参数,显存与并行配置同样照搬默认值。Meta Infer 的做法分两步:先做算模协同,通过内核补齐、修正页尺寸与元数据、替换不适配的旧内核、放宽通信快路径的生效阈值,把本就存在、却被适配问题锁住的性能放出来;再做通算重构,对注意力与投影等关键算子做融合,把计算与集合通信在时间上重叠,并针对预填充与生成两个阶段分别配置并行策略、动态调整显存与缓存参数。
拿 DeepSeek V4.1 Flash 来说,在 8 张只走 PCIe 的显卡上,社区基线版本的输入吞吐只有 1932 tok/s;完成算模协同后升到 5850 tok/s,再叠加全套通算重构,最终达到 13274 tok/s,整体提升 6.87 倍,并支持 1M 超长上下文。同样的方法论用在 DeepSeek V4 Flash 上,输入吞吐由 14546 tok/s 提升到 22584 tok/s,约 1.55 倍;用在 GLM5.3 上,从 3236.78 tok/s 升到 6222.72 tok/s,约 1.92 倍,首 Token 的 P95 时延从 141.6 秒降到 46.6 秒,上下文上限也从 27 万 Token 扩展到 105 万 Token。
把整机拉到与顶级 GPU 同一标尺上,差距比直觉更小:在单机 8 卡、5 秒、768P、16:9 的口径下,该整机文生视频做到每小时 296 条、参考图生视频每小时 131 条,而 B300 的对应数字是 439 条与 225 条,两者约为对方的 67% 和 58%。按吞吐折算,缓存方案几乎无损时,2.6 台 6000D 的产能约等于 1 台 B300 的文生视频,参考图生视频约为 2.9 台;再加上 LoRA,这一比例缩小到约 1.5 台和 1.7 台。视频模型 MiniMax H3 上,15 秒参考图生视频端到端提速 2.48 倍,峰值显存与稠密基线持平。
这套思路同样覆盖国产加速卡:需要显式启用面向该平台的稀疏注意力实现,关闭面向其他平台默认开启的专家融合,并把预填充与生成阶段的通信模式分别配置。仅把共享专家与路由专家改为两条流并行提交,在 35 组同配置配对测试中就带来 11.26% 的吞吐提升。全程不改模型权重与结构,也不改变业务语义——在硬件上限由芯片决定的前提下,把能发挥出多少交还给软件。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复