国产通用图形处理器又交出一份对比数据。在10月28日的“从模型到世界”媒体开放日上,天数智芯把新一代人工智能芯片天垓300的实机搬到了现场,并安排了与H200的同场测试。
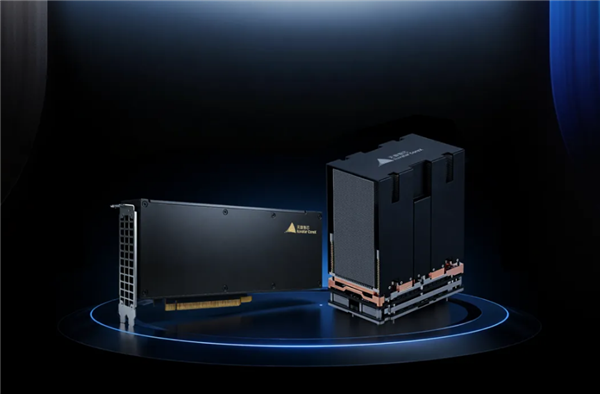
演示覆盖大语言模型、文生图与文生视频三类负载,对照模型包括GLM 5.3。按现场公布的结果,天垓300在三类场景中的整体表现均优于H200。训练侧那场演示用的是Qwen3 32B模型、八卡整机、FP8精度,单卡有效吞吐跑到H100的1.33倍。
这款芯片并非首次露面。今年7月的世界人工智能大会上,天垓300已经正式发布:架构叫天数天枢,里面塞了新一代Tensor Core,显存给到144吉字节,标量、矢量、张量三种计算模式都能跑,精度上FP8、FP4、BF16与FP16都在支持列表里,并具备高速片间互联能力。
第三方数据也摆了出来。上海仪电今年7月完成的实测显示,在大模型常见的预填充与解码分开部署的条件下,单卡折算后的端到端吞吐是H200的1.05倍,这也是国内第一款实测摸到H200水平的通用图形处理器。
更细的场景数据来自天数智芯性能实验室:上下文拉到64K时,注意力计算的性能是H200的1.05倍;GLM 5.3在同样规模、体验不打折的前提下,混合专家吞吐是H200的1.15倍;上下文从8K拉到128K,智能体吐第一个字的时间比H200少了一到三成;多模态生成推理吞吐高出约2%至5%;搜广推这类在线业务中,推荐推理这一项的吞吐高出21%,轻量计算的时延少了26%。往交付端看,天垓300已经形成从加速卡、一机八卡服务器到超节点的完整方案。IXL144超节点把一个标准机柜塞满,装了144颗图形处理器,显存合计约10.1太字节,每百万有效词元的成本比国际主流方案低约40%。
需要冷静看待的是,厂商自测与客户实际部署之间常有差距。芯片能否站稳,最终取决于编译器成熟度、框架适配广度以及长时间训练的稳定性,这些指标不会出现在一页对比图表里。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复