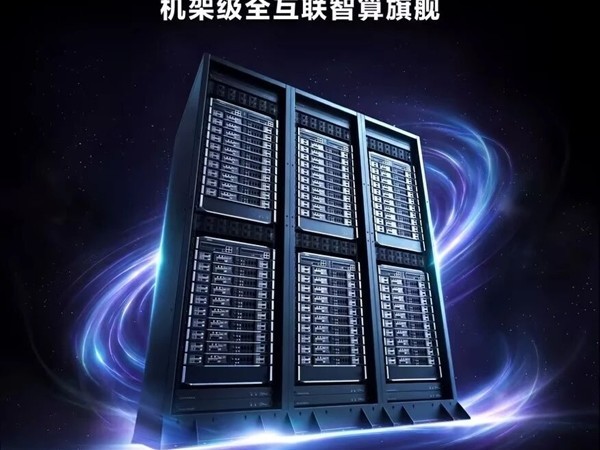
国产算力又往“系统级”方向迈了一步。9 月 29 日,新紫光集团旗下新华三发布了一款机架级全互联智能计算旗舰——这款名为 UniPoD S81000 X1 的超节点,核心思路是不再单比一张卡的强弱,而是把几十张国产加速卡连成一张高速网。
需求侧的压力来得很直接。AI 智能体正加速进入企业日常流程,单次任务吞下的词元数量普遍在十万到百万这个量级,比传统对话交互高出数十倍。第三方调研显示,已部署智能体的企业里有 37% 进入实际应用阶段,其中逾六成用户反映,实时互动的延迟明显高于预期。通信效率不足,成了卡住整体算力释放的那根绳子。
问题出在组网方式上。传统八卡服务器多靠以太网堆叠,卡与卡之间的互联时延徘徊在微秒级,带宽上限大约百 Gb/s。面对万亿参数混合专家大模型需要的全连接通信,大量算力被耗在等待数据传输上,硬件利用率很难拉满。
S81000 X1 给出的是一套系统解法。单个扩展域最多可容纳 40 张国产加速卡,同时用 4 个专用交换板卡搭起一级 CLOS 全互联拓扑,任意两卡之间的点对点带宽能做到 448GB/s。当中关键的一招叫正交连接:计算节点和交换节点用高速连接器直接对接,省掉线缆与背板后,信号走得更短、损耗也更小;全程靠电互联、不用光模块,物理可靠性据称提升十倍。
协同层面,40 张卡聚合后形成一块 5760GB 的显存池,地址统一编址;全面支持 FP8 精度运算,整机总算力 28P FLOPS,足以覆盖万亿参数大模型训练与推理一体化的需求。部署上它遵循 19 英寸标准机柜规格,单个机柜最高能塞进两套 40 卡系统,可直接接入现有数据中心。
散热采用以液冷为主、风液兼容的架构:CPU 与 GPU 等高热密度部件配备冷板式液冷,新建机房可以直接上液冷,存量风冷机房也能借风液 CDU 方案平滑过渡。从芯片、互联、散热到调度运维,国产智算的比拼重心明显已从单卡参数转向全栈能力,这款超节点正是这一转向的注脚。
把视角拉远,这类超节点折射的是国产算力路线的切换:从追单卡指标,转向用互联、显存池化与散热工程把整体效率抠出来。对正在把智能体塞进业务流程的企业来说,能不能稳定、低延迟地跑起大模型,往往比某一张卡的峰值参数更重要。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复