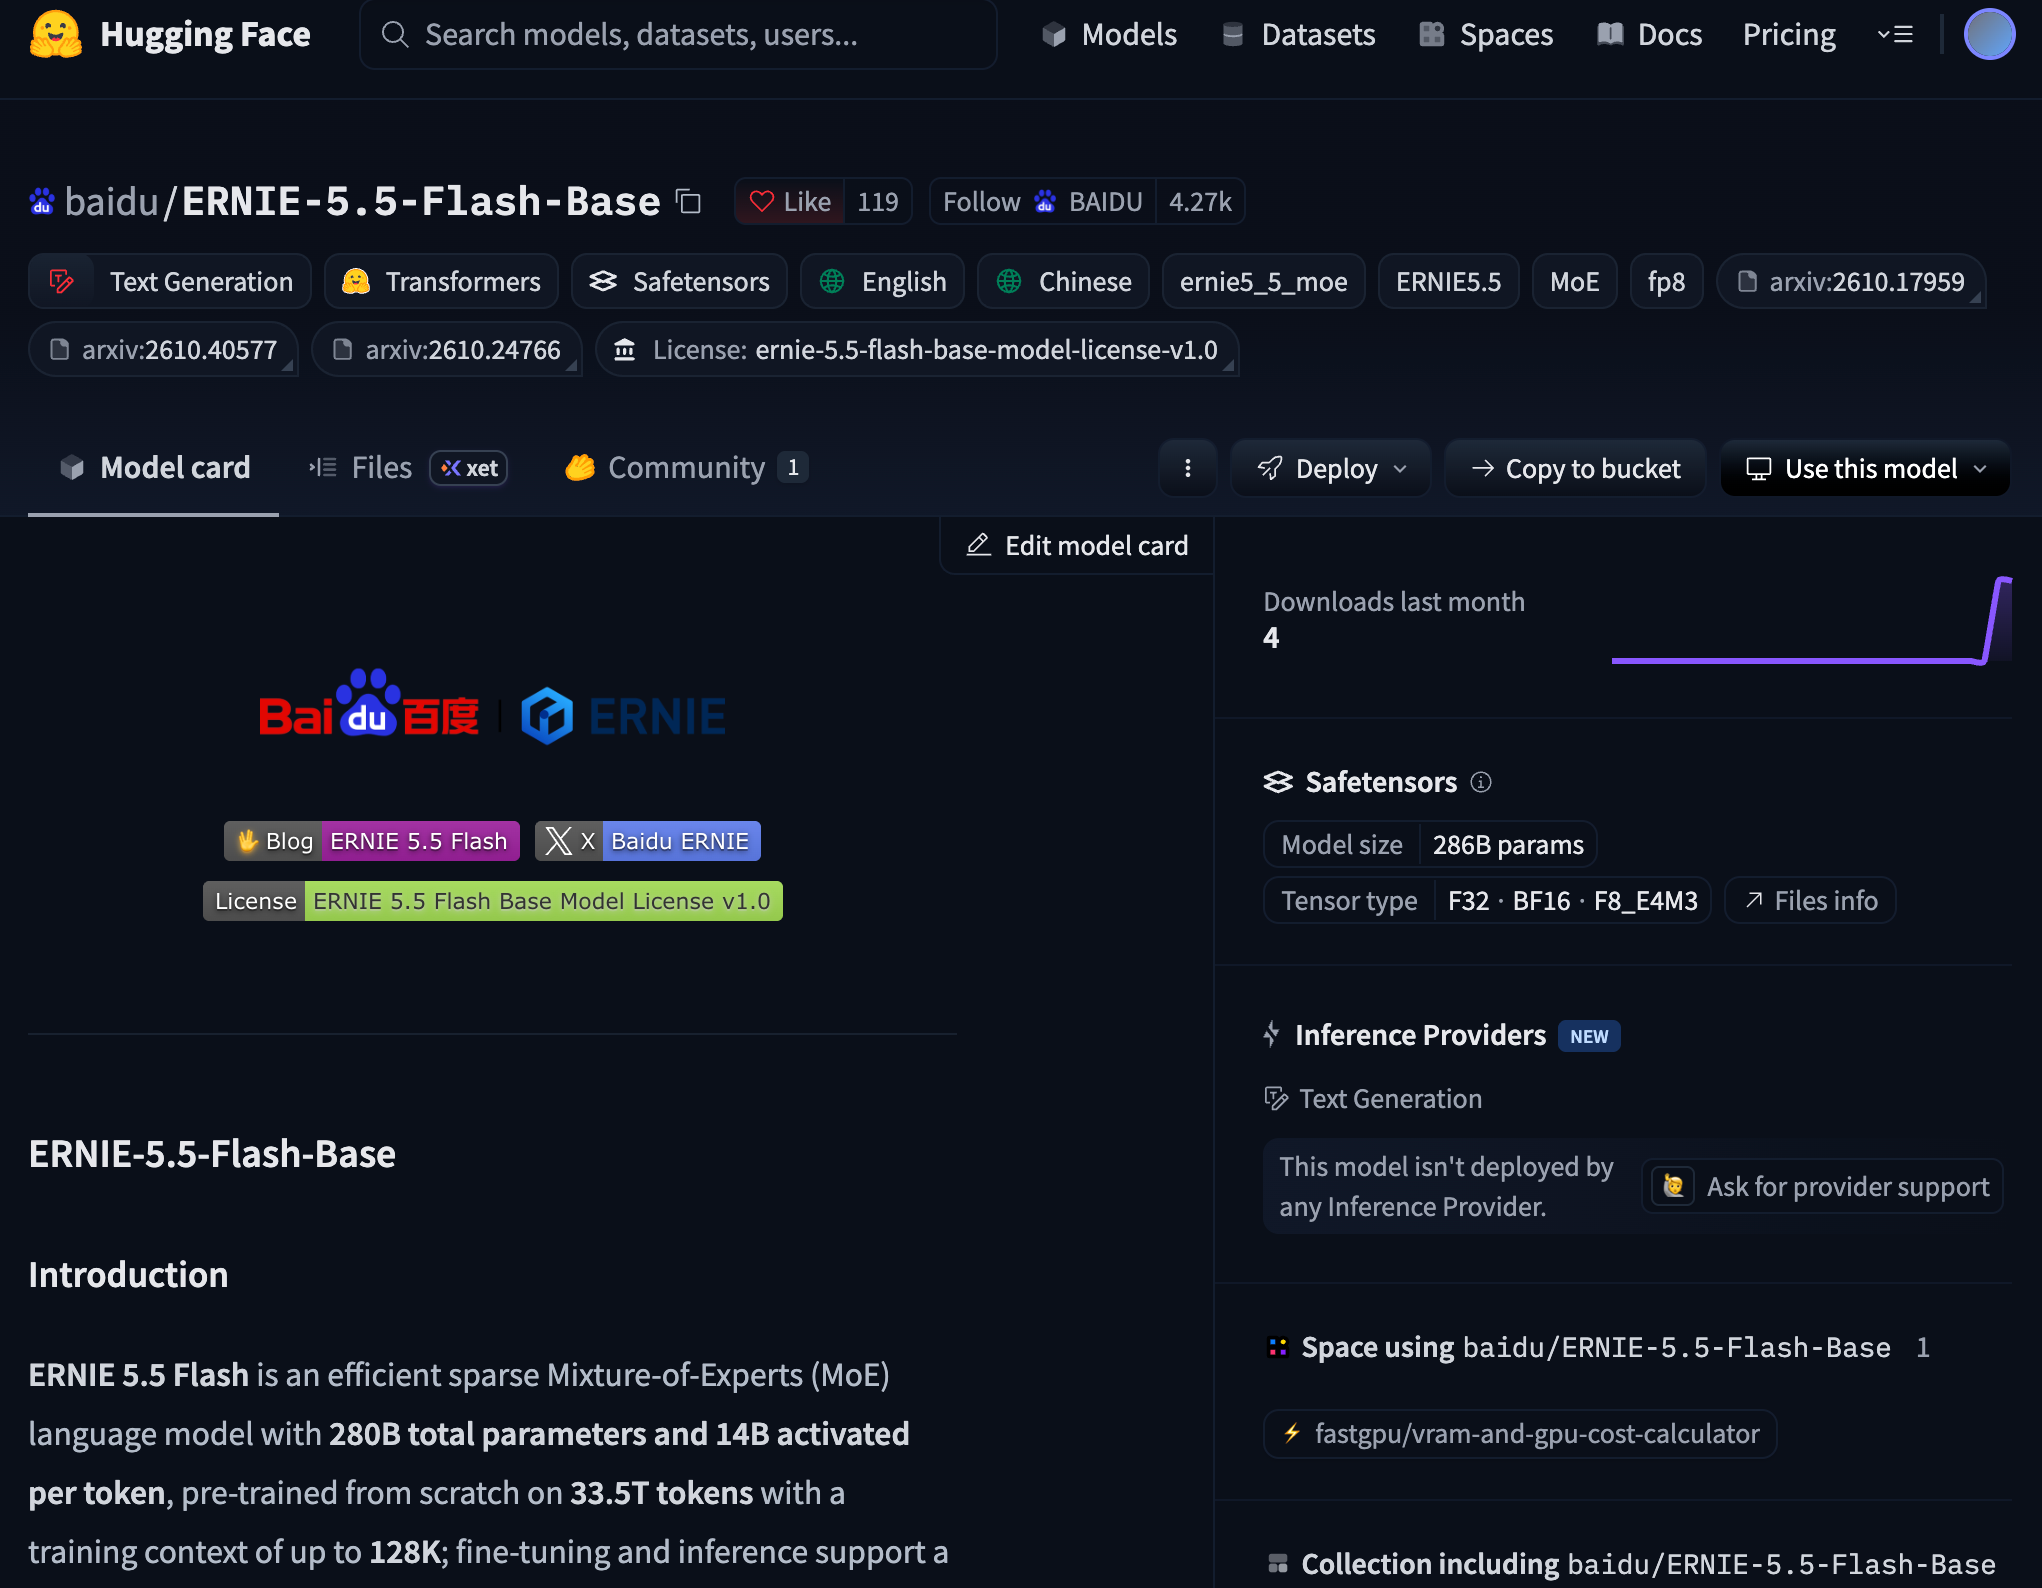
百度十一月五日发布并开源了文心 5.5 Flash Base。这是一款稀疏混合专家架构的基座模型:总参数两千八百亿,每个词元只激活一百四十亿,在三十三点五万亿词元上从零完成预训练,训练上下文最长十二万八千,微调与推理阶段则支持一百万词元。
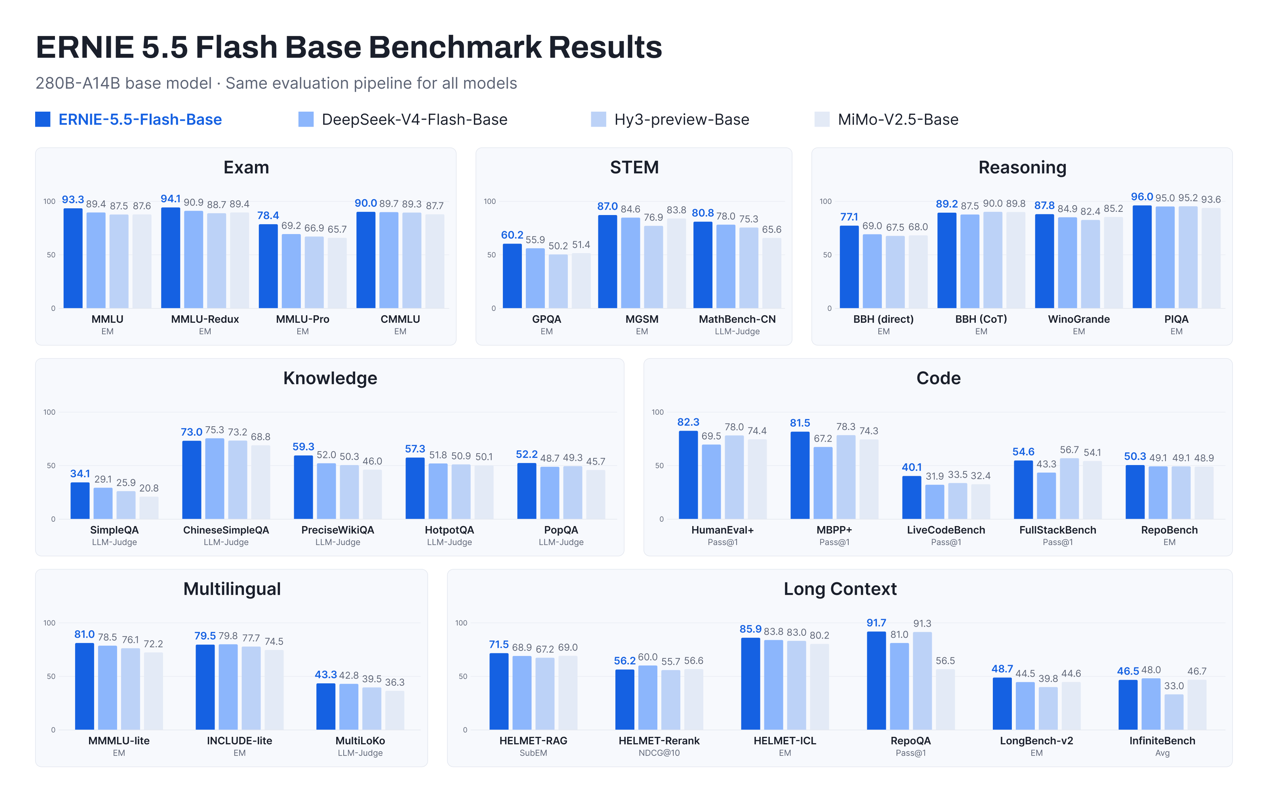
在同尺寸基座的对比里,它的对手包括 DeepSeek V4 Flash Base(二千八百四十亿总参数、一百三十亿激活)、Hy3 preview Base(二千九百五十亿、二百一十亿)以及 MiMo V2.5 Base(三千一百亿、一百五十亿)。按百度公布的评测,它在推理、代码、学科能力与长上下文任务上取得领先,拿下同等规模的最优水平。
支撑这组成绩的,是架构、数据与训练系统三处同时下手。模型共四十三层,隐层宽度四千零九十六,注意力头六十四个。稀疏设计让它在算力预算可控的前提下装进更多专家知识——这句话说起来简单,做起来要在每个环节抠效率。
第一处改造在注意力。它把重度压缩注意力与多头潜在注意力组合成混合稀疏结构,四十三层里有三十七层用前者,其余六层用后者。压缩层的做法是把每一百二十八个词元压成一条缓存条目,注意力只在压缩条目加最近一小段未压缩窗口上计算,等于大部分层看"摘要"就能把握全局,键值缓存的开销大幅下降。
但压缩会丢细节。需要精确定位历史信息时,那六层保留全量访问的注意力就派上用场;为进一步控制开销,团队在其上加了稀疏检索:一个轻量索引器会给每个查询在历史上打一个分,核心注意力只挑得分靠前的若干位置做精细计算,开销不再随上下文线性增长。官方披露,引入这套机制后,这几层的预训练损失与稠密注意力持平,训练速度明显提升。
此外还有两处细节:门控改用注意力层自身生成的低秩查询潜变量来计算,投影权重参数少了七成五;跨头之间加了一层轻量的低秩混合,推理时可融进算子,额外开销很小。
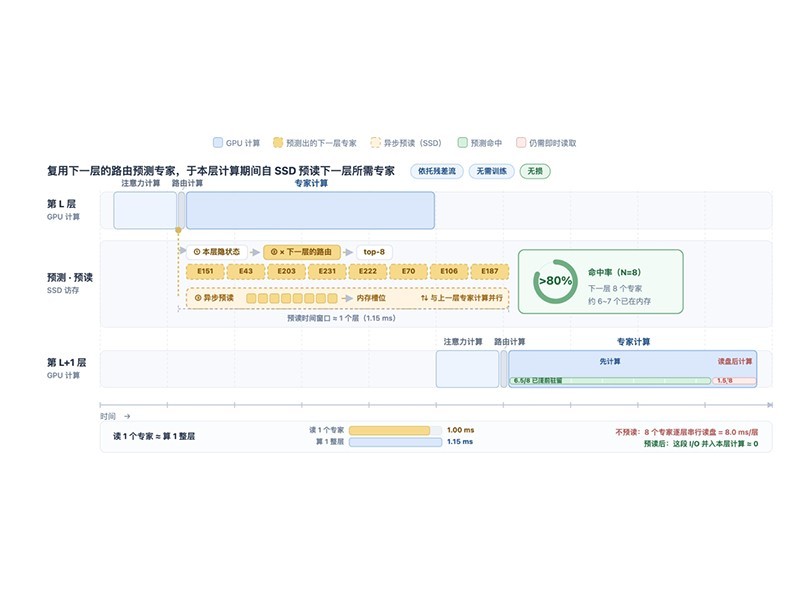
第二处改造在专家路由。传统混合专家只用一个路由器打分再硬选,问题在于打分与专家真正能起的效用只是弱相关,越往深层越明显,落选专家拿不到梯度,选错一次就很难纠正。文心改用多个独立初始化的路由器共同打分,只要某个专家被其中一个强烈看好、或获得多个认可,就有机会入选,等于给选择加了几个独立视角。关键在于成本没涨:激活专家数、专家算力与通信量都与单路由器相同。
专家计算本身也压过一道。词元先由四千零九十六维投影到二千零四十八维,专家在低维空间里算完再映射回去,算力与分发合并的通信量大约减半。路由配置是五百一十二个专家里选十个,外加一个共享专家。
第三处改造叫 ECHO,盯的是未来词元预测。业界常见的多词元预测会在主干之外加专用模块,损失主要作用在新模块上,主干各层仍只服务下一个词元。ECHO 反过来,直接让主干最后一层承担多步预测,损失因此落到生成下一个词元的参数上,逼着主干提前学会序列往后怎么展开。它还能直接充当投机解码的草稿模型,不增加参数,起草的接受率高于同样方式训练的外挂模块。
配套的还有几项工程改动:输出头用可学习的分段温度调制不同词元的分布,压长尾又保留多样性;分词器换成全新的字节对编码方案,词表约二十万,数字按从右到左、最多三位一组切分,方便处理算术与数字密集文本;训练侧用 Muon 优化器配 FP8 混合精度,并推出面向大维度的注意力算子,改善通信与显存效率。
目前开放的是预训练终点的权重,尚未做中训练与后训练,开发者可以在这个统一起点上做领域适配、指令微调、推理强化与智能体训练;官方同时与 vLLM、SGLang 这些社区联手,给出对应的生态支持。文心 5.5 Flash 正式版将于近期发布。
从竞争角度看,同尺寸模型的比拼已经落到每个词元的激活效率、长上下文的处理成本,以及底座能力能被复用到什么程度。谁把这些设计沉淀进预训练阶段,谁在后续迭代里就更从容。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复