让 35B 级别的多模态模型跑在手机上,过去听起来像玩笑:全部权重约 65.6GiB,相当于主流 16GB 机型内存总量的四倍多。行业给出的标准答案通常是压缩、裁剪,或者干脆把任务丢给云端。
面壁智能与 OpenBMB 社区一起发布并开源了 MiniCPM V 4.7,一次性推出 35B A3B 与 1B 两个版本。前者冲击端侧能力上限,官方称其是全球首个能在端侧无损流畅运行的开源 MoE 多模态模型;后者则负责把门槛压下来。
问题的核心是一个不可能三角:参数要大、内存要小、效果不能掉。参数越大越依赖云端,内存压得越紧精度越容易牺牲,速度提上去又常常伴随能力滑坡。
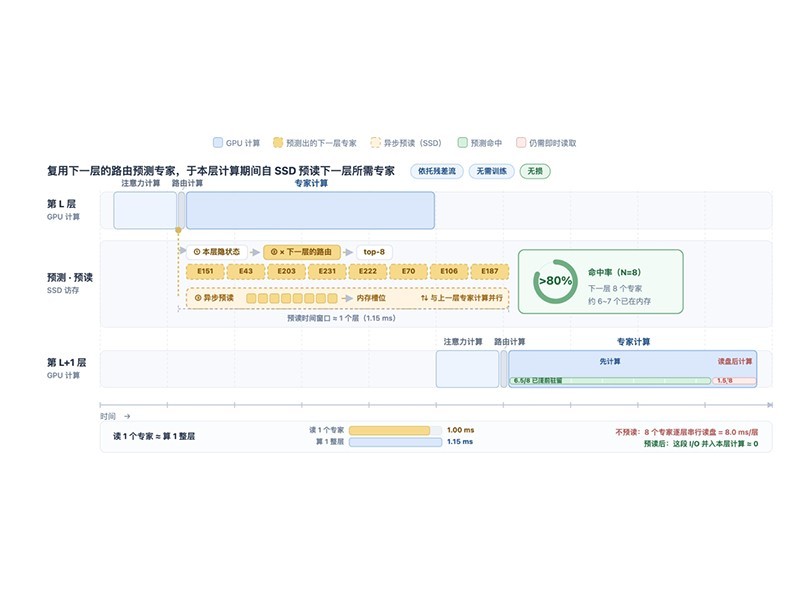
面壁的解法不是在内存里硬塞模型,而是让模型不必全部加载。借助 MoE 混合专家架构与名为 LES 的前瞻专家调度方案,大部分专家留在固态硬盘里,需要时再读入,形成边算边读的节奏。
难点在于等待。传统 MoE 放到端侧,某一层该叫哪些专家,得等前一层算完才定得下来,硬盘读取也只能从那一刻起步,于是每生成一个词元都要停一次,等数据到位。
LES 的突破口来自一个观察:模型的信息是逐层累积的,相邻两层的输入差别很小;路由模块挑专家,说到底是按分数取头部,输入稍有波动,排序通常不会翻盘。于是系统把当前层的路由特征喂给下一层的路由模块,一边算当前层,一边预测下面要用谁,再由后台线程提前把数据搬进内存。
更关键的是,预判只决定提前搬谁、先算谁,不决定最终用谁。每个词元实际调用哪些专家,仍由原始路由根据真实输入选定,没被预判到的专家也会正常加载。因此开启 LES 后,输出与关闭时一致,提速不以精度为代价。
官方测试显示,这套方法无需额外训练,多数场景能提前备好超过八成的专家,速度平均快了约五倍。在 16GB 的 iPad Pro M4 上,每秒能出 17 个词元以上;换成 18 Pro Max 则超过 20 个,内存占用只有约 3GB。
能力层面,35B A3B 版在 OCR 与图表、长视频、通用视觉、STEM 等任务上表现突出,官方称 34 项基准里领先同档的 Qwen3.6 35B A3B,也超过体量更大的 Qwen27B 与 Gemma 4 31B。体积更小的 1B 版同样开源,两项常用评测的分数是 OCRBench 86.10 与 MMBench 83.17,面向入门设备。
链路效率也做了配套:输入端支持 4 倍与 16 倍混合视觉压缩,输出端用了 DSpark 投机解码,轻量草稿模块先给出候选,主模型再并行核验,官方给出的生成速度平均提升为 1.17 倍。
生态方面,模型已经适配 NVIDIA、ARM、Intel、AMD、瑞芯微、后摩智能等厂商,并通过 FlagOS 打通海光、沐曦、平头哥、昆仑芯、天数智芯、华为、摩尔线程等芯片平台,软件侧兼容 Ollama、MLX、llama.cpp、SGLang、vLLM 等推理框架。
当 35B 级多模态模型只需要约 3GB 内存就能跑,端侧 AI 的想象空间会被重新划线:隐私数据不必出门,响应不必等网络,成本也不再按调用次数计费。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复