模型决定能力上限,推理框架决定这些能力能以多低的成本交付。10 月 20 日,这家公司宣布把内部使用的推理框架 DeepInfer 整体开源,等于把自家大规模部署的工程经验交到开发者手里。
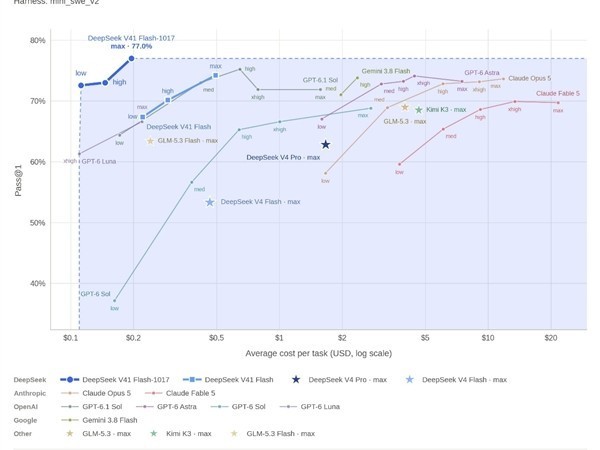
这套框架不是实验室产物。它已经承担 DeepSeek V4.1 Flash 的线上推理,撑起了高吞吐、低延迟的大规模服务;后续新模型的推理代码与性能优化,也会继续在这个开源项目里更新。社区拿到的,是与线上服务同源的那一套,而不是阉割版。
官方对中间层的定位说得很清楚:能力上限由模型本体决定,但要以可控成本承接海量请求,框架才是关键。训练让模型成型,推理让模型可用。算力集群怎么调度、请求怎么排队、显存怎么复用,全靠这一层,它的效率直接决定服务的开销与能耗。
这也不是公司第一次开放技术栈。此前它已陆续放出模型权重、TileLang 编译工具与推理算子库,如今补上框架,整条链路的对外透明度进一步提高。官方的期待是:帮开发者与企业改善吞吐与延迟,让私有部署和公有云部署都更从容,从而降低算力成本、减少能源消耗。
技术层面,DeepInfer 内置高性能算子与深度优化的引擎,支持分布式推理、推测解码、有界滑动窗口重放与结构化输出;硬件侧同时兼容英伟达与华为昇腾两条路线。双平台兼容这点尤其关键——在高端算力供给受限的现实下,同一套框架能否在国产芯片上跑出可用性能,直接决定很多企业的选型空间。
与框架一起开源的还有配套的词元编解码组件,官方称其为生产级,逻辑与自家接口保持对齐。开发者能获得一致的调用体验,从实验环境迁移到生产环境时,适配成本被压低。
从行业视角看,推理层的开源竞赛刚开始。模型开源解决"有没有",框架开源解决"用不用得起"。当单次推理的成本被压到足够低,智能体、长上下文检索、批量文档处理这些吃算力的场景才具备商业可行性。把最难复现的工程经验公开,短期看是让利,长期看是在为自己主导的技术路线扩大生态基本盘。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复