DeepSeek 把大模型更新到 V4.1 Flash 1017。在国产大模型密集迭代的节点上,这次更新没有改 API 价目表,而是把力气花在了单位任务的实际消耗上。
官方首次自主发布了一条帕累托前沿曲线,把效率与成本放在同一张图里比较。V4.1 Flash 1017 在这条曲线上处于领先位置:做完同一件事,综合开销只有 Fable、Astra 这些同级产品的百分之一到二十分之一,性价比差距在四五十倍以上。
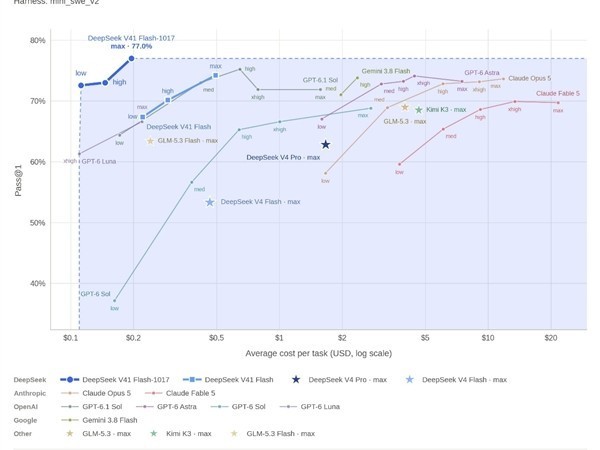
这样的成本控制并非临时降价换来的。DeepSeek 长期在底层工程上做优化,尤其集中在硬件适配与推理效率。参考 SemiAnalysis 的 AgentX 基准,在 GB300 NVL72 平台配合 Dynamo vLLM 推理框架时,V4.1 Flash 每花 1 美元可处理 13 亿 Token,用户侧 P90 交互延迟稳定在 10 毫秒以内,相当于每秒输出超过 100 个 Token。
折算下来,每百万 Token 花在算力上的钱只有 0.00077 美元,而当前 API 对输入 Token 标价 0.15 美元。两个数字口径不同:前者是纯算力端的总拥有成本,后者还要覆盖服务运营、模型维护与弹性扩容等商业开支。正因为底层资源利用率足够高,终端定价才有腾挪空间。
市场反馈来得很快。OpenCode、CommandCode 等平台推出的十美元档套餐,标价虽低,可用额度却相当于 80 到 120 美元,OpenCode 还开放了免费调用通道。在聚合路由网络中,V4.1 Flash 的每月调用规模已达百万亿 Token,一家平台扛下的量抵得上六到七家同规模竞品。
横向看,在万亿参数以内,其余主流开源模型每单位产出的总拥有成本,普遍达到它的十倍;参数规模扩展到 1.5 万亿至 3 万亿时,差距拉大到 40 至 50 倍。需要说明的是,这些成本数字来自上一版 Flash 0910 的测算。
1017 版本真正的变化在效率层:靠任务感知压缩、上下文动态裁剪以及自适应解码,压低每次请求真正烧掉的 Token。实测多数场景下用量比前一版下降超过一半,同等价格下能完成的工作更多,折算后的总拥有成本还会继续下探。对开发者而言,这比单纯降价更实在——账单上的数字,最终取决于每一次请求到底烧掉多少 Token。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复