一个机器人连续五次没能完成任务,多数人会判断它不会做。商汤在测试 GPT 6 Astra 时遇到了相反的情况:RoboDojo 仿真评测里的九个任务原本五次全败,在没有重新训练模型、只把交互步数上限提高到原来十倍之后,结果变成五次全成功。
有些失败,其实是停止得太早。但一直等下去同样有代价。在扩展预算的实验,叠碗这一项平均要跑 131 分钟,推理费用估算 19 美元;装笔入筒更慢,平均 263 分钟,费用约 55 美元。任务最终完成了,可这样的机器人离日常使用还很远。
商汤用 12 个模拟评测、8 款机器人做了一轮系统研究,同时把日日新 SenseNova RoboRSI 框架,以及一个 27B 的具身模型,宣称把任务完成成本降到 GPT 6 Astra 的五十分之一。
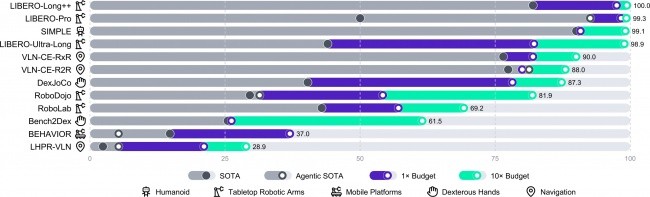
研究先划出能力上限。团队解除了两个限制:允许模型访问训练集,先学习再实践;以及解除步数上限,最高放宽到各榜单官方设置的五倍至十倍。放开之后,GPT 6 Astra 在 LIBERO 系列桌面机械臂任务与 SIMPLE 人型机器人移动操作任务上表现已完全饱和,在 RoboDojo 上的任务成功率也达到 81.9%。
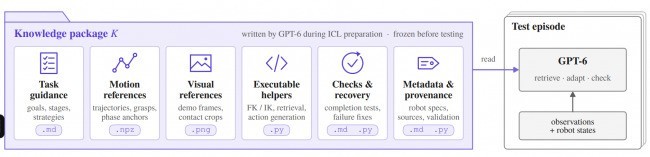
过程中还观察到模型的思考方式。执行任务前,它会研究示范中的图像、机器人状态与动作轨迹,把把关键信息做做成任务笔记,也整理参考动作与代码工具,正式测试时再结合现场观察调用和调整。通常每个任务只需准备一次,之后可复用于多次测试。
但榜单逼近上限,不等于可以落地。商汤列出四类瓶颈。第一,经验跨任务迁移能力有限,通过上下文学习获得的提升高度依赖本体演示数据,单个任务形成的技能包迁移到新任务时效果打折。第二,执行成本与商业可行之间仍差几个数量级,一个对人极简单的装笔动作要花 263 分钟与 55 美元。第三,长序任务是明显短板,在大场景轮臂作业与需要探索的长序视觉导航上表现最弱。第四,稳定性不足,模型有时无法确认任务是否完成,有时处理不好物理状态变化,也会在多个子任务之间顾此失彼。
于是问题变成:能否让慢思考的大模型与快思考的小模型协作,在控制开销的同时保住性能?实验比较了三种分工。直接委托不检查结果,开销低但性能严重受损;审核动作再执行的闭环方式性能有提升,开销却没有优势;目前较有潜力的组合是大模型加上下文学习加快模型闭环,在 RoboDojo 的 42 项任务中成功率达到 54%,成本问题依然存在。
真机实验进一步暴露差距。GPT 6 Astra 可以操作所有受测真机,擅长桌面抓取,但面对柔性材料操作、精细插接、长序导航仍显吃力。在主动视觉方面表现亮眼:一次插花实验中它因为看不清瓶口,它把空闲的那条机械臂挪过来,借另一只手上的相机补上视角,再完成插入。现实世界的麻烦则更直接:碰撞或电机过热会导致停机,任务具有时间敏感性,无法像仿真那样无限重试,现场还常常缺少演示数据。
开源部分是这次的重点。SenseNova RoboRSI 把各榜单及运行依赖封装成独立容器镜像,通过统一接口提供环境交互与原生评分,让评测环境与模型、策略解耦。研究者不必手动部署复杂仿真环境,准备好配置文件就能一键跑完端到端评测并复现结果。
同步推出的 27B 预览版模型,把把目标理解、动作决策与反馈纠错这些能力压进参数中。它在 RoboDojo 上取得 26.13 分、任务成功率 20.83%;在 LIBERO Pro 上,无论快慢协同还是大模型直接控制,成绩都突破 90 分,仅次于 GPT 6 Astra;在 RoboCasa365 上成功率从 26.0% 提升到 46.5%,任务所需的 Token 开销下降 73%。
商汤的结论是,评测不该只数动作成功与否,还要看机器人能否理解人的真实需求、能否通过交互积累经验、能否在世界继续变化时及时完成任务。这套框架的价值,在于把问题发现、实验验证与方案迭代接成了一条可复现的链路。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复