这家国产大模型厂商在 10 月 17 日通过公众号发布更新说明,其主力模型已迭代到新版本,网页端、手机应用与接口侧的模型同步切换为新版本。
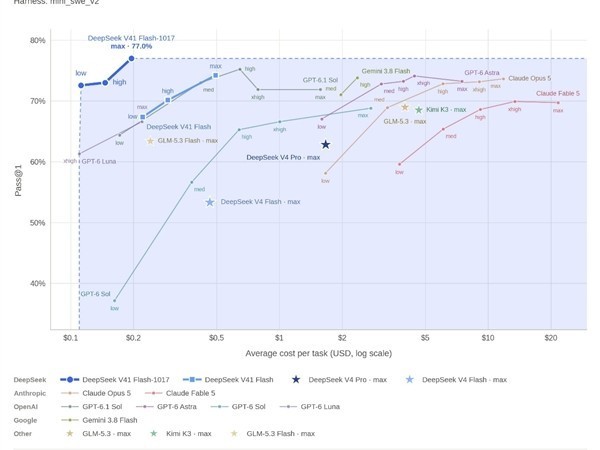
官方给出的变化集中在两处:多项基准测试的成绩有明显提升,同时任务耗时与输出长度都被压缩。这两项优化叠加起来,意味着同样的任务可以用更少的词元消耗和更短的等待时间完成,官方将其描述为性能与成本之间的帕累托最优。
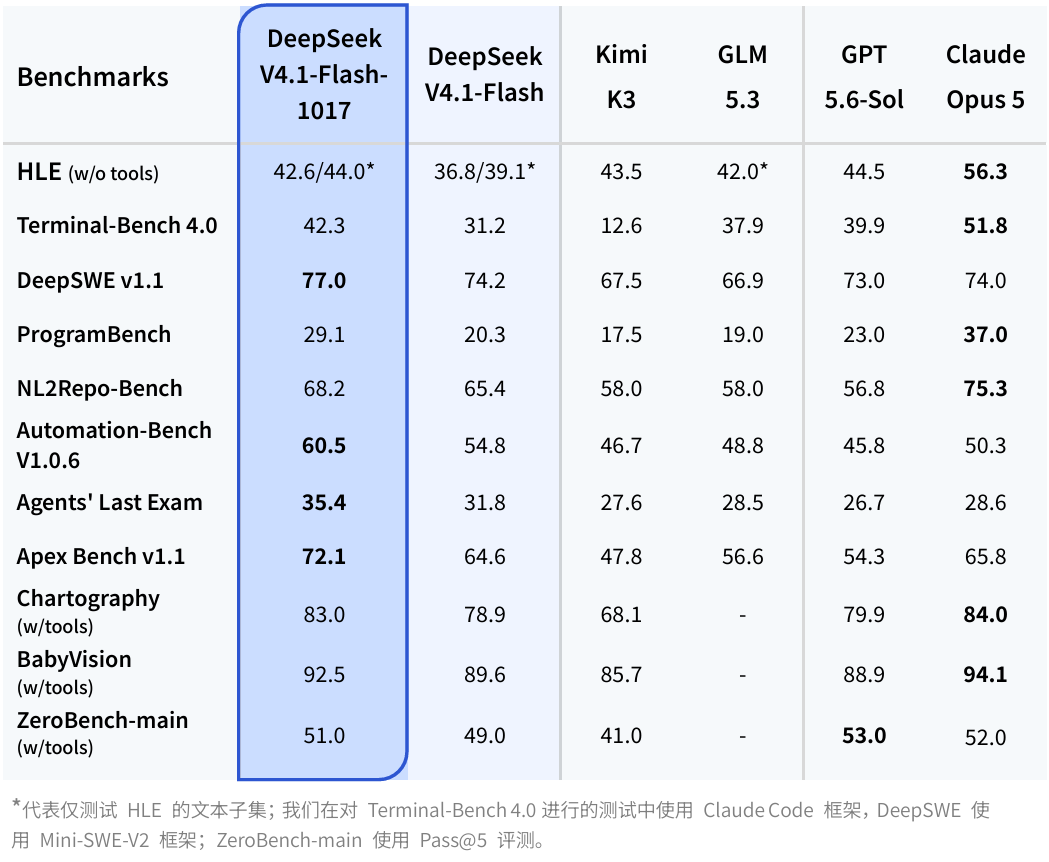
版本迭代背后是训练方法的调整。新模型引入自反馈强化学习方案,重点强化“从零搭起一个完整项目”的能力,覆盖游戏开发、三维建模这类需要连续多步操作的场景。这也解释了官方为何频繁提到“许愿式编程”——用户只需描述想要的结果,模型自行拆解步骤、编写代码、反复调试。这类任务的难点不在单步生成,而在长链条上的自我纠错,自反馈机制正是为此设计。
比模型本身更值得注意的,是接口能力的扩展。其接口新增搜索与抓取两项能力,正式对外开放网页检索与取页服务。此前开发者想做检索增强,通常得自己对接外部搜索服务,再处理解析、清洗与拼装;现在这一步可以由平台直接完成,工程链路的复杂度随之下降。
计费方式采用了按成功请求结算的规则:计费标准为每千次成功调用 5 元。所谓成功请求,指的是真正返回结果的调用,失败或空结果不计入。对调用量波动较大的应用来说,这种计费方式比按调用次数一刀切更容易控制成本。
官方同时给出了过渡期安排:眼下在 Claude Code、Codex 与 Harness 这些场景里,通过服务端调用暂时不扣费,正式计费从 11 月 1 日 0 点开始生效。这段时间既留给开发者做压力测试,也留给他们评估检索增强究竟能给产品带来多少实际增益。
把这次更新放到更大的背景里看,模型厂商的竞争正在从“谁的分数高”转向“谁能让应用更快落地”。搜索与抓取属于典型的基础设施型能力,它决定了一个模型能否接入实时信息、能否处理需要外部知识的任务。当这类能力被标准化并以极低单价开放,上层应用的创新门槛会被进一步压低,而厂商之间的比拼也会更多落在稳定性、延迟与生态工具上。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复