国产大模型厂商DeepSeek(深度求索)于9月1日将V4 Flash Vision实验版模型上传至Hugging Face平台,并以MIT许可协议完整开源。这是DeepSeek V4系列推出的首款原生支持图像输入的多模态模型,权重文件、分词器、提示编码参考实现以及一套极简的PyTorch推理代码全部对外公开,开发者可以本地部署并二次开发。
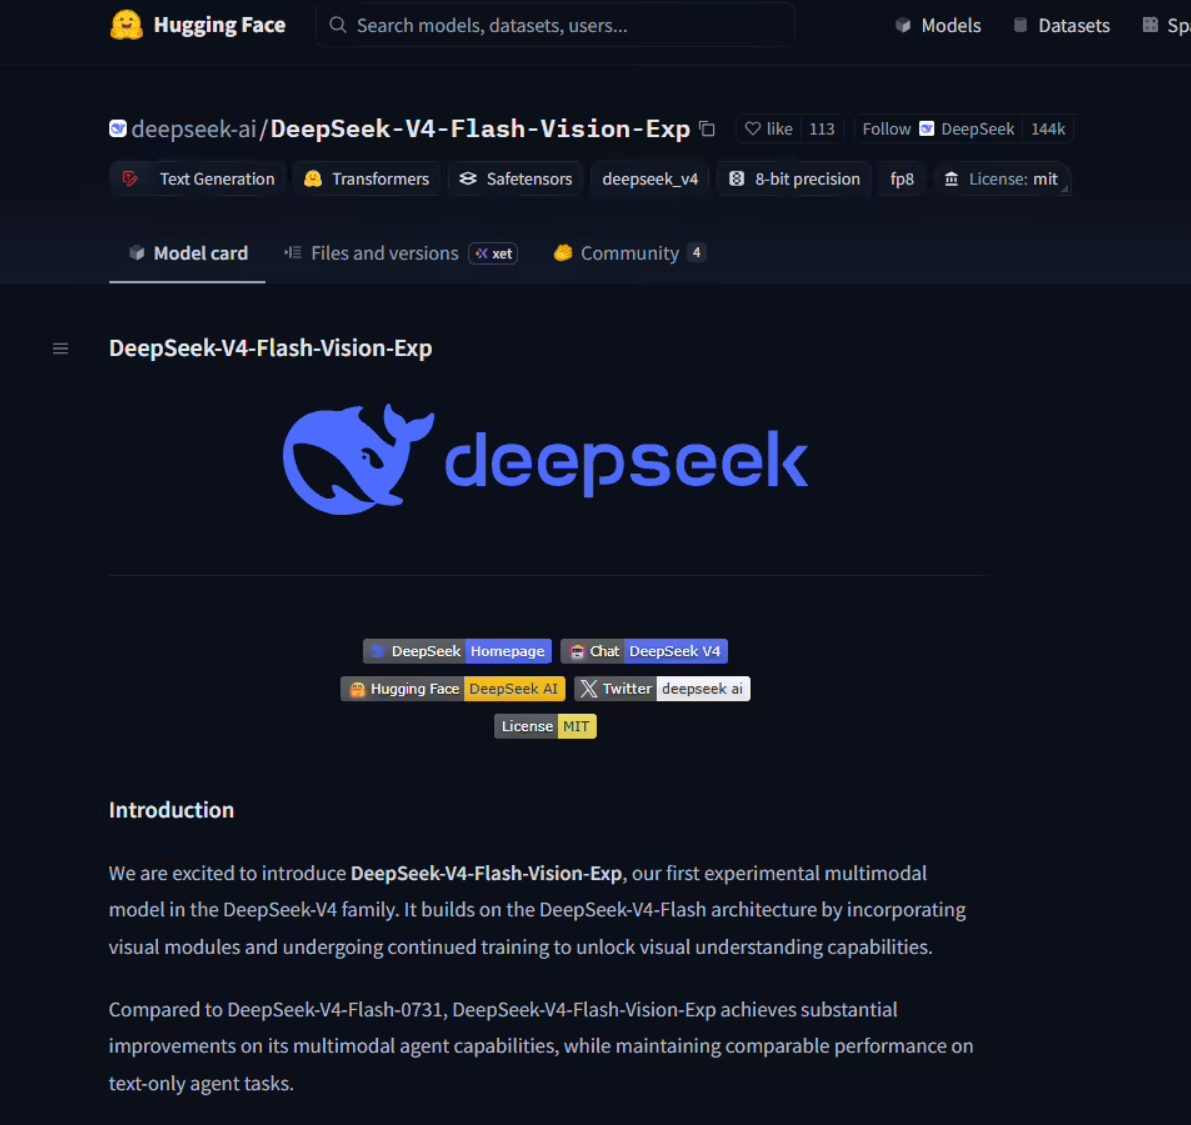
从技术构成看,该模型在V4系列文本模型的基础上集成了视觉编码器与对齐模块,并保留MoE架构、超连接结构与稀疏注意力等既有设计,推理代码中还包含针对显存效率优化的稀疏注意力实现。官方文档显示,模型的API说明页早在8月21日下午就已先行上线,此次开源属于研发节奏的自然推进。
能力层面,模型原生接受图像输入,可以完成图像描述、截图文字识别(OCR)、图表解析等典型视觉理解任务,支持JPEG、PNG、GIF与WebP格式。在文本任务上,它的表现与此前发布的V4 Flash正式版保持一致;而在视觉Agent相关的基准测试中,模型提升明显,多模态智能体能力已接近业界头部闭源模型Opus 4.8的水平。官方同时表示,模型已适配主流Agent开发框架,方便开发者把视觉理解能力接入自动化工作流。
此次开源延续了DeepSeek一贯的激进开放路线:此前V4系列文本模型已经以MIT协议开源并登上多个开源榜前列,这次多模态模型的加入,让开源阵营补齐了视觉理解这一关键拼图。对企业与开发者而言,可商用、可魔改的许可协议意味着可以较低成本把视觉能力嵌入自有产品,例如截图问答、票据识别、图表数据分析等场景都能直接调用或微调。
有分析指出,头部厂商通过开放权重抢占开发者生态,正倒逼更多闭源模型在性价比与服务上做出调整。随着V4多模态版本正式开放,下半年开源与闭源模型在视觉理解赛道的竞争预计将进一步升温。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复