腾讯全球数字生态大会现场,两家公司一起推出了基于至强 6+ 的新一代云实例,同时把一套面向智能体的基础设施方案摆上了展台。
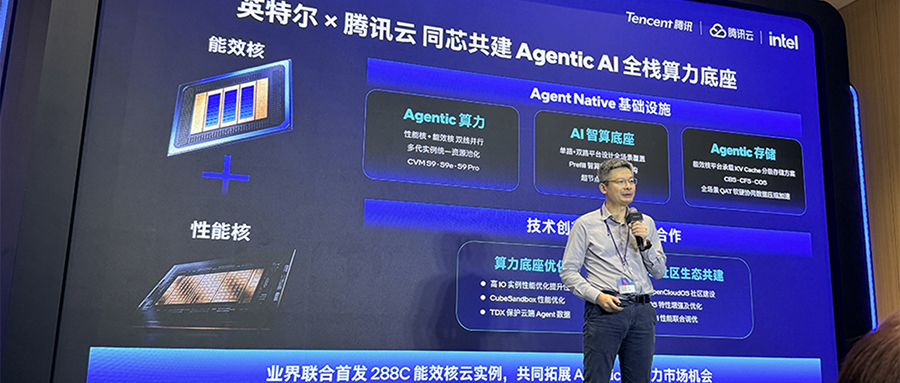
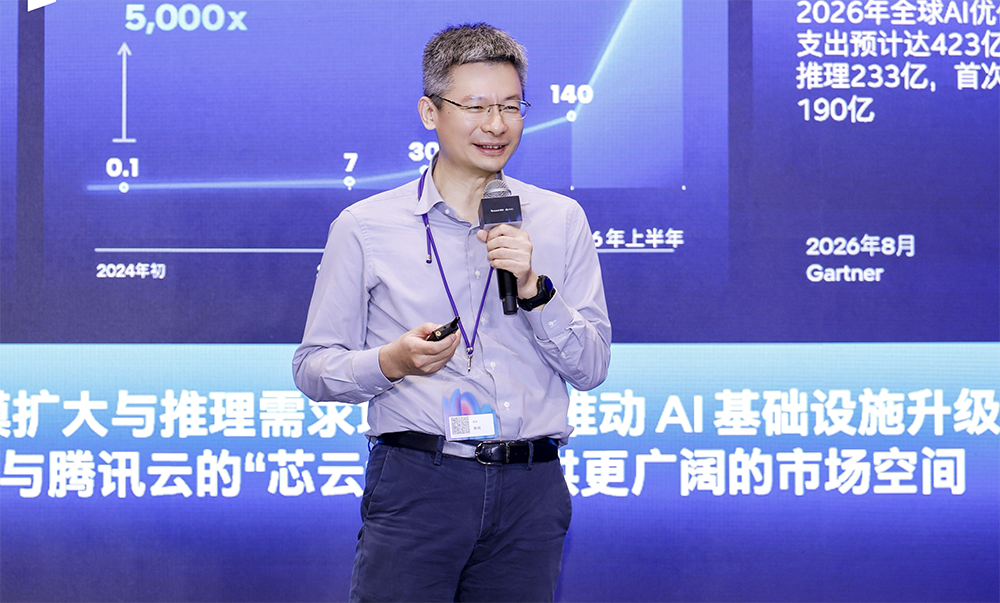
先看芯片。至强 6+ 最高拥有 288 颗能效核,单颗处理器最多可支撑超过一千个智能体稳定部署,这为云服务器带来了更高并发、更低时延与更优能效。基于该平台的新实例,综合性能比上一代提升三成以上,适配云原生微服务、高并发网页与智能体任务编排等场景。
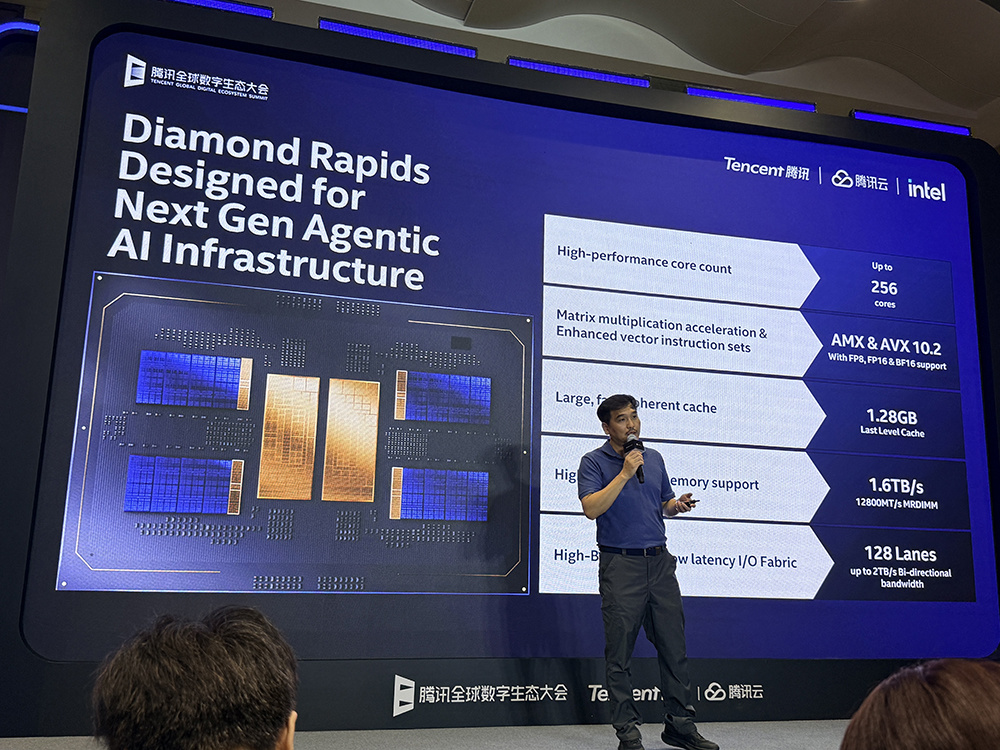
安全方面,新实例引入信任域扩展技术,靠硬件隔离与认证,给智能体一层“数据可用不可见”的可信环境。面向下一阶段更高密度的调度需求,英特尔还准备了代号叫 Diamond Rapids 的下一代至强。
真正见功夫的地方在内存。智能体跑得越多,KV 缓存越要在不同层级之间流动、压缩与调度。腾讯团队最初试过软件压缩方案:单路解压时延尚可接受,多路并发之后最大时延冲到 5 毫秒,还带来内存带宽争抢,无法满足业务要求。
转折来自处理器内置的内存分析加速器。双方把压缩与解压交给硬件,团队对内核驱动做轻量适配、简化调用路径,并比较了多种批量并行配置,最终选定八批量方案。效果是 2M 页的解压延迟被压到微秒量级,平均耗时快了 16 倍,最坏情况也快 9 倍。该方案已在腾讯云完成验证并上线。
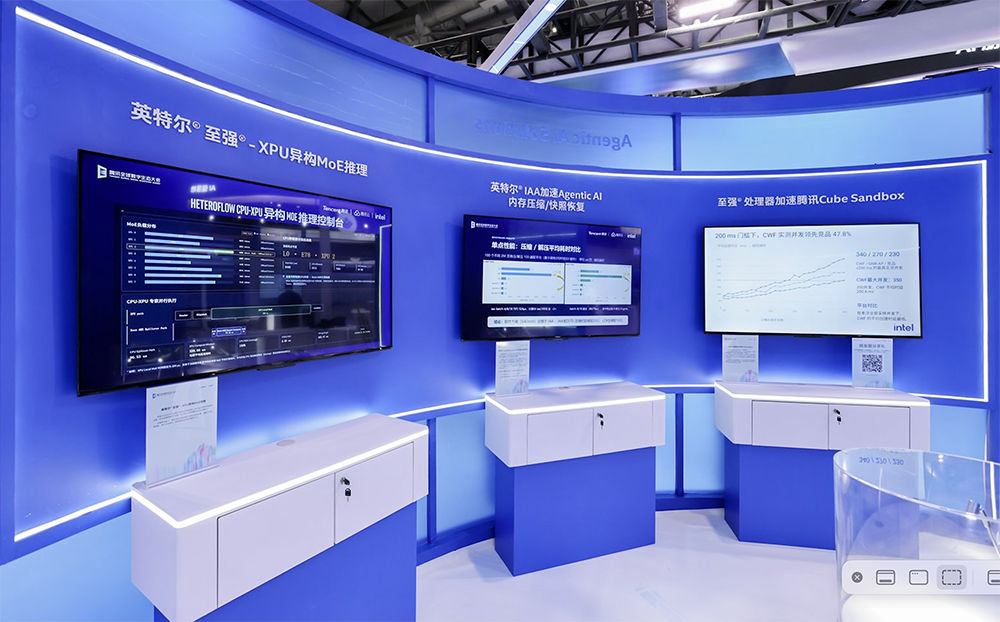
沙箱是另一处瓶颈。智能体要随叫随到,就得在极短时间内批量拉起执行环境。基于至强 6+ 与腾讯云开源沙箱平台 CubeSandbox 的协同,在满足 200 毫秒服务等级要求的前提下,一台机器能同时拉起 350 个沙箱,比其他主流测试平台高出约 46%。软件侧也做了准备:资源提前池化、未修改的内存与磁盘内容尽量共享,相关优化还合入了 OpenCloudOS 内核。
多模态任务则交给处理器的矩阵加速引擎。腾讯云的多模态计算引擎 Xpark 用它承接小模型推理与轻量任务,在视频处理工作流中,转码性能比开源方案提升 1.5 倍,目前已经上线。
硬件组合还在扩围。英特尔 GPU D 系列架构为 Xe3P,功耗框在 350 瓦以内提供LPDDR5X 容量给到 480GB,带宽 1.5TB 每秒,FP8 算力 1.3 PFLOPS,瞄准持续运行的内存密集型推理。软件栈坚持开源并优先回馈上游,覆盖主流训练与推理框架。
英特尔中国区总经理郭威表示,双方会继续深化“芯、云、端”协同,把算力底座做厚。从内存压缩到沙箱启动,再到多模态处理,这场合作的看点不在单点参数,而在把每一段链路的损耗都压下去。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复