据第一财经报道,8月21日下午,DeepSeek官方API文档的模型详情页面上线新模型DeepSeek-V4-Flash-Vision-Exp,这是V4系列中首款原生支持图片输入的视觉模型,标志着DeepSeek在多模态方向迈出关键一步。
参数规格方面,该模型具备100万上下文窗口,最大输出长度384K,支持JSON输出、工具调用、Responses API、Anthropic API兼容以及对话前缀续写。图片将依据尺寸折算为Token,与文本Token合并计费,计费逻辑清晰透明。
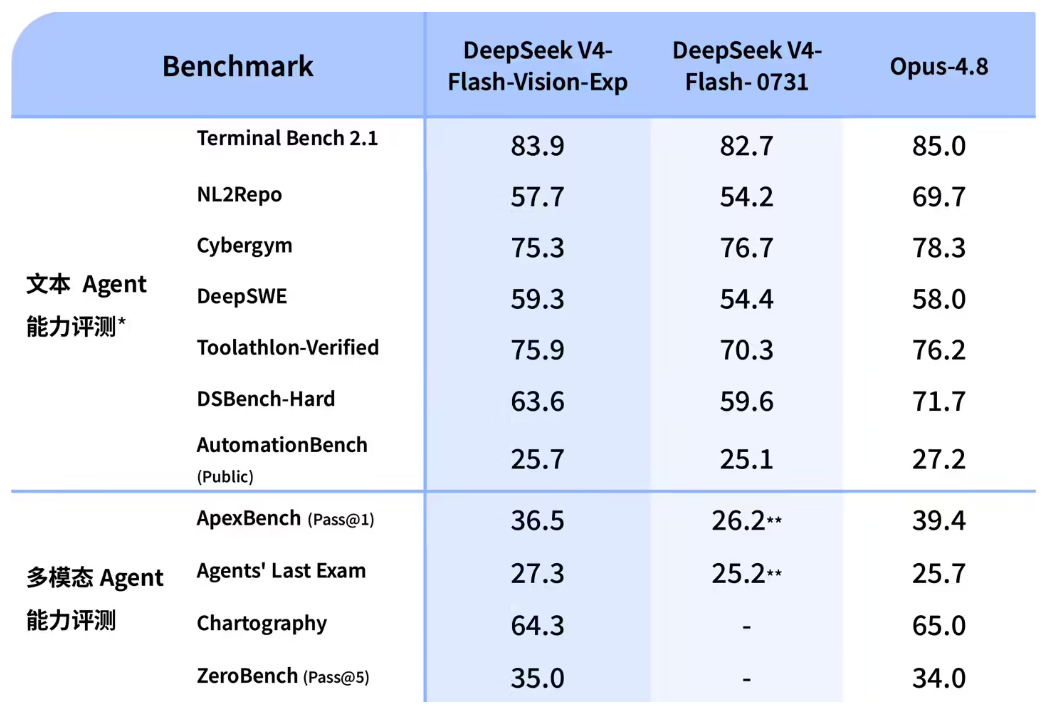
能力表现上,在纯文本维度,DeepSeek-V4-Flash-Vision-Exp与DeepSeek-V4-Flash正式版持平,延续了V4系列扎实的语言能力;而在需要视觉理解的Agent Benchmark上,相比DeepSeek-V4-Flash实现了大幅跃升,多模态Agent能力已接近Opus-4.8的水平。这意味着模型不仅能"看懂"图片,更能将视觉理解融入多步骤任务执行,向真正的多模态Agent迈进。
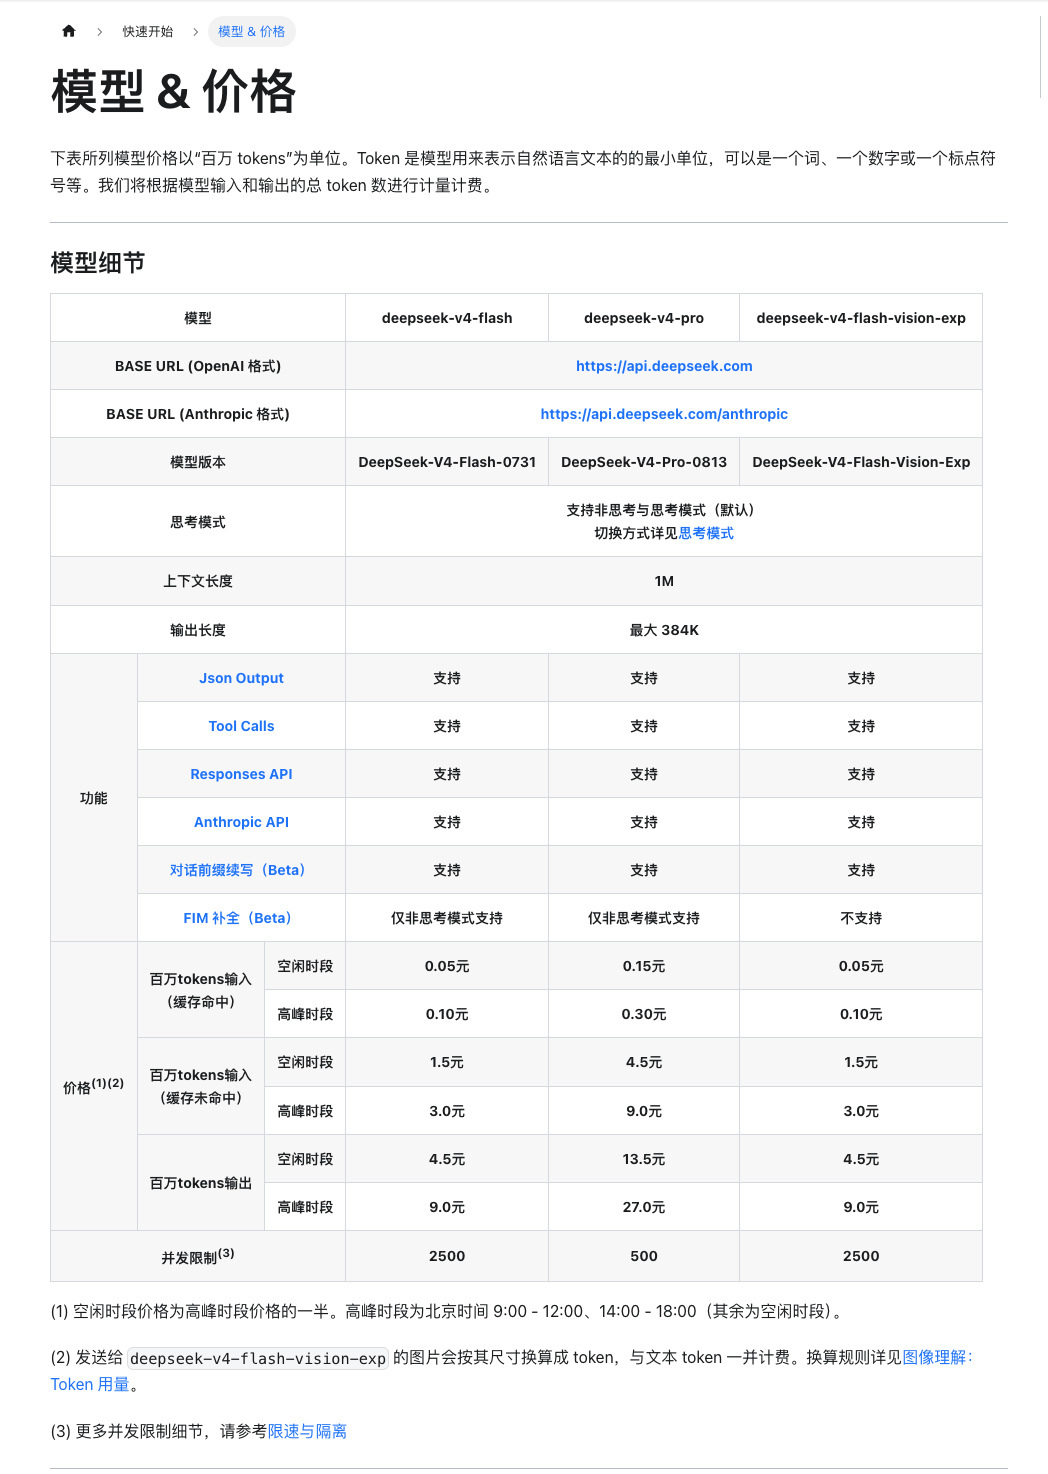
定价层面,DeepSeek-V4-Flash-Vision-Exp现阶段API资费与普通V4-Flash保持一致,延续了DeepSeek一贯的性价比路线:缓存命中场景下,空闲时段0.05元/百万Token,高峰时段0.10元/百万Token;缓存未命中时,空闲时段1.5元/百万Token、高峰时段3元/百万Token;输出Token空闲4.5元/百万Token、高峰9元/百万Token。
从时间线看,距离DeepSeek开源Agent Harness框架刚过去一周,视觉能力便完成接入。以往相互独立的模型、图片、文件、工具、Agent执行链路得以打通,DeepSeek补齐了Agent体系重要的感知输入环节——对于开发者而言,这意味着可以用更低成本构建具备视觉能力的自主Agent应用。
随着视觉模型的加入,DeepSeek的模型矩阵更加完整。在国产大模型加速向多模态、Agent化演进的浪潮中,DeepSeek-V4-Flash-Vision-Exp的落地,为开发者提供了又一个高性价比的选择,也让多模态Agent的普及门槛进一步降低。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复