小米的大模型又在架构上做了一次升级。据小米 MiMo 官方消息,MiMo V3 启用了名为 HySparse2 的全新核心架构,在上一代 HySparse 的基础上进一步改进了 KV 共享与稀疏选择机制,目标是让模型更省、更准地处理长上下文。
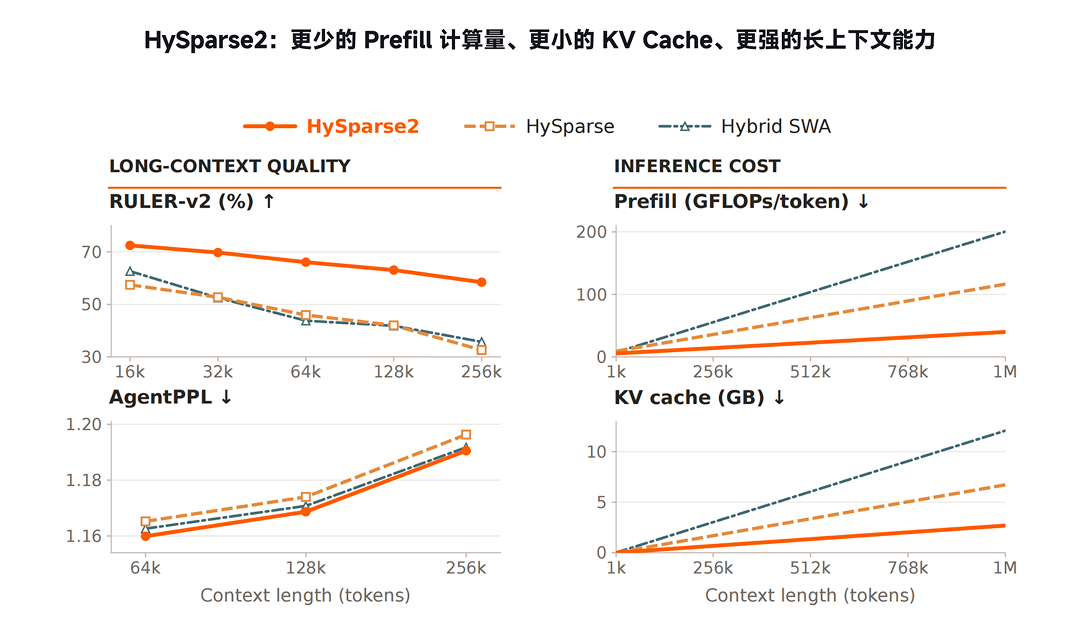
这套架构面向的是长程多轮智能体场景:更少的预填充计算、更小的 KV 缓存、更精准的长上下文检索。小米的大模型负责人罗福莉介绍,智能体推理是一种比较特殊的工作负载——每一轮交互里,简短的动作指令往往换回一大段需要预填充的文本,上下文持续膨胀,于是预填充成本、缓存规模和检索准确率就成了性能瓶颈。
官方测算,当上下文达到 100 万 Token 时,预填充环节的计算量下降约 5.02 倍,KV 缓存占用则减少约 4.5 倍;同时 MRCRv2 与 RULER v2 分数更高,AgentPPL 与 LongPPL 更低,说明处理长文本时的准确度并未被牺牲。
实现路径上,HySparse 2 引入了 KV 桥接机制,参考 YOCO 的思路,让负责交叉解码的那部分注意力层,直接借用自解码器的隐藏状态来生成键与值;在同一计算块里,稀疏层的缓存与选择索引可以直接沿用上一层的注意力结果。此外还有两处改动:用 Token 粒度选择取代过去的块级选择;以靠前的近期 Token 强制窗口,取代原本独立的滑动窗口分支,让本地与全局 Token 共用一套缓存。
由此,预填充流程在自解码器算完后就能收尾,不必再走一遍完整计算。此前小米还发布并开源了 MiMo V2.6 系列,包含 Pro 与 Flash 两个版本,都是原生全模态模型。从 V2 到 V3,小米在长上下文这条赛道上明显加快了脚步,架构迭代的节奏也越来越紧凑。
总体来看,长上下文正在成为大模型竞争的焦点之一。谁能在不显著抬高成本的前提下把上下文做得更长、更准,谁就更容易在智能体与文档处理这类场景里占住先机。从 V2 到 V3 的这次架构切换,说明小米不打算在这条赛道上落后。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复