9 月 28 日,阿里巴巴把自家的大模型伏渊息壤推到台前。在 CyberGym 这个被视作国际权威的 AI 安全能力评估平台上,它于最新一期模型榜单里以 88.9% 的成功率排在首位,也成为该榜创建至今首个登顶的中国团队自研模型。
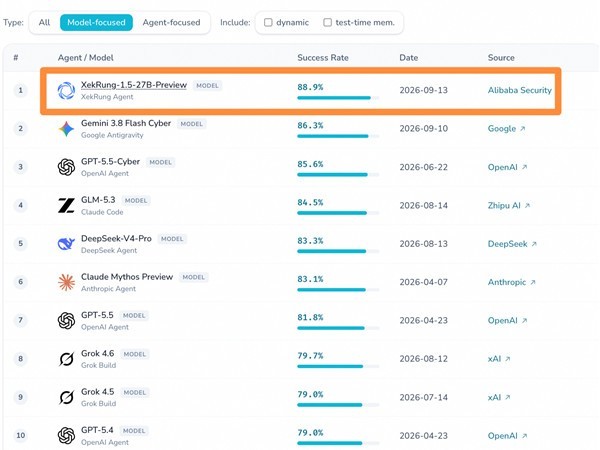
更值得留意的是它的体量。伏渊息壤的参数量只有 270 亿,是同榜其他主流安全大模型的一个零头,区间大致在二十七分之一到三百七十分之一之间。这种小而强的路线,把识别安全漏洞所需的算力开销压了下来,让高水准的 AI 安全能力更容易被广泛落地。
评估本身的分量也值得一提。CyberGym 由加州大学伯克利分校的团队牵头搭建,被视作全球公信力最强的 AI 安全能力评估体系之一。它的覆盖面不小:188 个真实软件项目、1507 个经人工核验的已知漏洞都在测试范围之内,用来衡量模型能否理解复杂安全问题、给出靠谱的推理与修复建议。榜单分成模型榜与智能体榜两档,前者要求只能用通用 Harness 框架,既不许预设流程,也不准接入外部工具或知识库,等于把焦点完全压在模型自身的安全智能上。伏渊息壤此次夺冠,正是出自这一核心赛道。
排在它身后的四家分别是谷歌、OpenAI、智谱以及 DeepSeek,对应成绩是谷歌 86.3%、OpenAI 85.6%、智谱 84.5%、DeepSeek 83.3%,名次之间的差距其实并不大,名次之间的差距其实并不大,伏渊息壤胜在更小的参数规模。
据官方介绍,伏渊息壤的底子是阿里自研的多模态基础模型 Qwen3.8 27B,再叠加安全领域的知识,借助高强度定向训练与智能压缩把性能顶了上去。它的参数规模远小于 GPT 5.5 Cyber 与 Claude Mythos 之类的对手,却在漏洞识别的准确率以及泛化能力上完成了反超,折射出安全大模型正从大而全转向精而专。
负责阿里安全 AGI 实验室的黄龙涛表示,人工智能已经深度嵌入系统安全防护体系,让漏洞发现的效率与风险响应的精度都得到明显提升。他强调,伏渊息壤以安全智能的性价比为设计原点,后续会在对抗性推理、自主演化以及智能体协同等方向上继续加码,并借助标准化的接口、开源组件以及行业协作机制,把安全能力向社会开放。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复