微软正式发布面向人工智能负载的Maia 300芯片。新品配备288GB的HBM4内存,内存带宽18TB/s,在FP4精度下的算力上限为13.8 PFLOPS,采用台积电N2P制程,计划2027年部署。
随着大模型参数规模持续膨胀,云厂商对自研AI芯片的投入明显加码。相比通用GPU,自研加速器可以针对自家数据中心的网络、散热与软件栈做深度定制,既有助于压低单位算力的成本,也能减少对外部供应商的依赖。微软的Maia系列正是在这一背景下持续推进的,其迭代节奏也牵动着整个AI基础设施的走向。
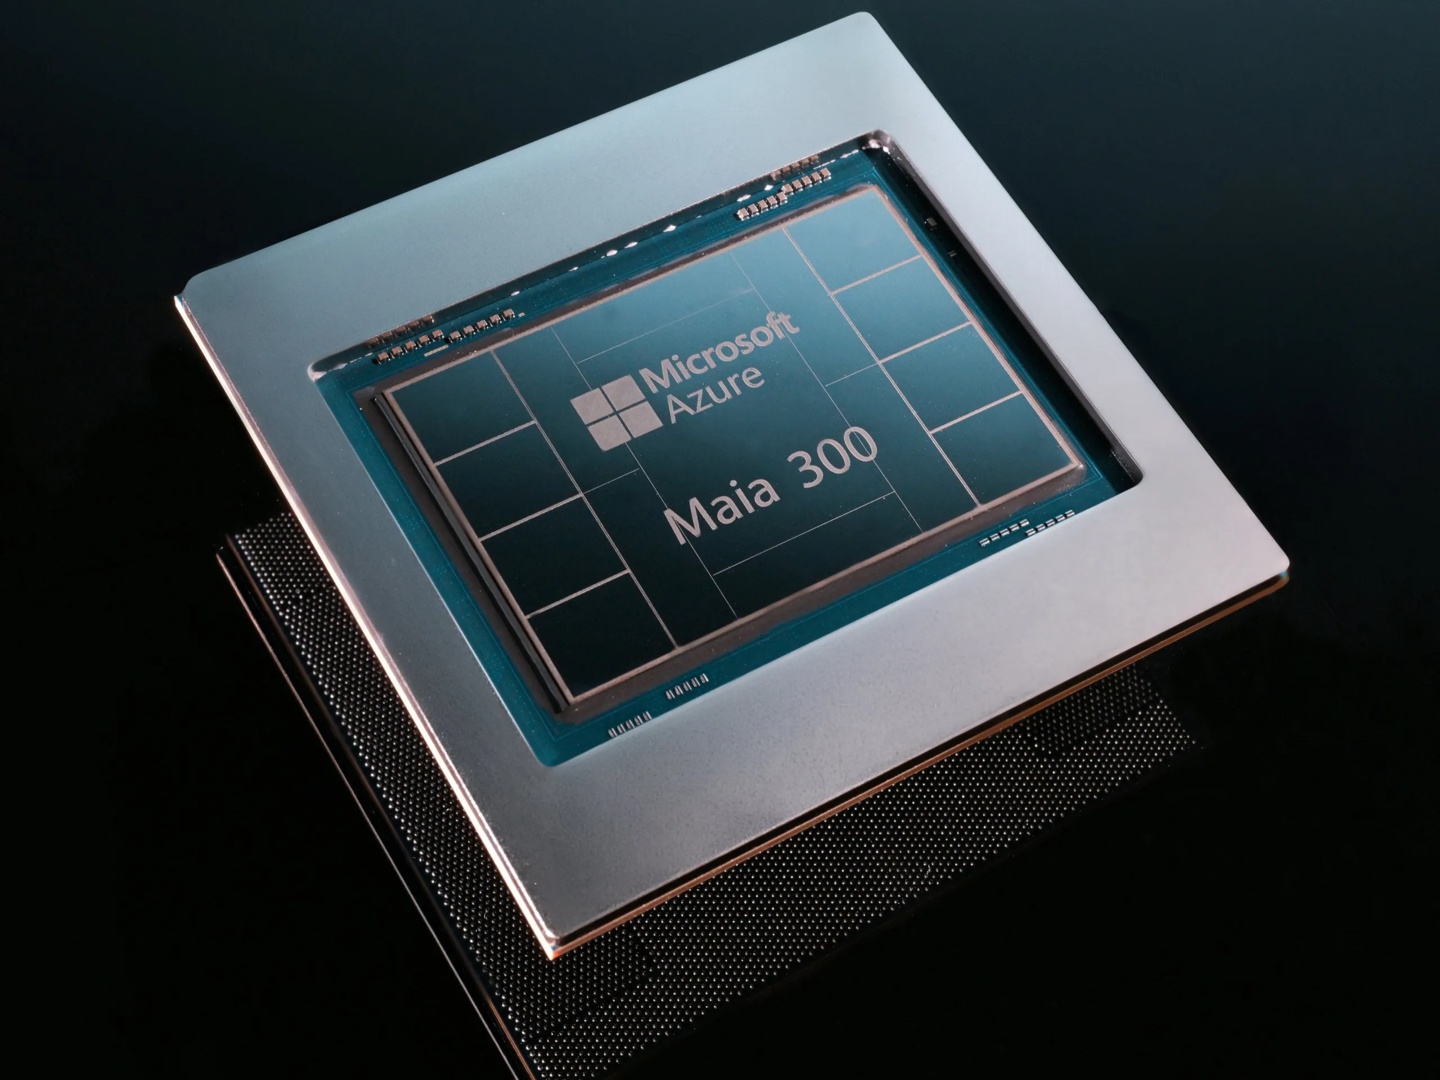
设计上,Maia 300采用多芯粒方案:主要计算部分基于台积电N2P 2纳米制程,另外集成独立的内存芯粒与I/O芯粒。算力方面,其FP4最高为13.8 PFLOPS,FP8为6.9 PFLOPS;它的SoC功耗额定达到950W,比Maia 200的750W高出不少,功耗的抬升也反映出性能与能效之间的取舍。
存储与互联是这款芯片的亮点。它配备8组HBM4内存,总容量288GB,带宽18TB/s,更适合对内存容量要求较高的AI推理任务;双向的扩展互连带宽为3.2TB/s,底层是一套基于以太网的双层网络。在部署形态上,一个机架就能装下96颗Maia 300,最多可以组成含有12000颗加速器的集群,为大规模AI推理与训练提供更紧凑、也更容易扩展的算力单元。
放眼市场,英伟达仍在AI加速器领域占据主导,谷歌、亚马逊等云厂商也都在推进各自的定制芯片。微软Maia 300的规格公布,意味着这条自研路线进入了新的迭代周期。后续的软件生态与开发者适配是否顺畅,将决定它能在多大范围内替代外购算力,也会影响云服务市场的成本结构。
在软件层面,微软也在同步推进配套的工具链与开发框架,以降低开发者迁移到自家芯片的门槛。能否把硬件规格转化为实际可用的算力,最终还要看生态的成熟度。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复