英伟达于2026年8月27日宣布,为其NVLink Fusion定制芯片生态推出全新内存组件NVHBM。该方案专为定制化AI加速器设计,是一种高度集成的高带宽内存解决方案,目标直指大模型训练与推理场景下的算力瓶颈。
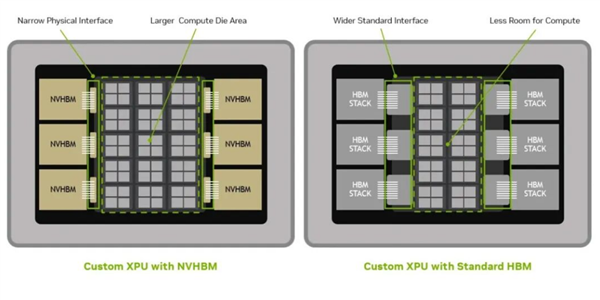
据官方介绍,NVHBM单栈带宽相较标准HBM4E最高可提升30%,同时具备更低功耗与更小的主芯片占用面积。其核心创新在于,将内存控制器从主计算芯片转移至HBM堆栈的基片内部。传统架构中,HBM内存控制器通常集成于主芯片之上,挤占了本可用于部署计算单元的宝贵硅片资源;而NVHBM通过控制器下沉设计,使主芯片可释放最多30%的逻辑区域,显著提升计算资源密度。
在能效方面,NVHBM较标准商用HBM4E降低约15%功耗。当应用于大规模芯片集群时,单颗芯片的功耗节省将产生显著的累积效应——既可将冗余功耗重新分配至计算单元以增强整体性能,也可在既定整机功耗预算内部署更多加速器节点,从而提升系统级的算力密度。
需要明确的是,NVHBM并非通用型HBM产品的替代方案,而是英伟达面向特定生态伙伴提供的底层基础组件。目前量产的Vera Rubin机柜级系统并未采用该技术,其目标应用场景是未来面向大模型训练与推理需求的定制化芯片架构。
英伟达已联合全球主流内存厂商完成NVHBM的设计开发与工程验证,亚马逊旗下Annapurna Labs成为首批合作方。该公司副总裁Nafea Bshara表示,此次合作将有力支撑AWS下一代云基础设施的演进,其正在研发的Trainium4 AI芯片已原生支持NVLink Fusion扩展接口,后续迭代型号将整合NVHBM技术。
此外,英伟达还向NVLink Fusion生态伙伴提供精简型定制PHY物理层IP模块,便于合作伙伴将其灵活集成至自有芯片设计中,加速定制加速器的落地进程。随着云厂商自研芯片浪潮持续升温,这类高度定制化的内存方案,正在成为AI算力军备竞赛中的新变量。文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复