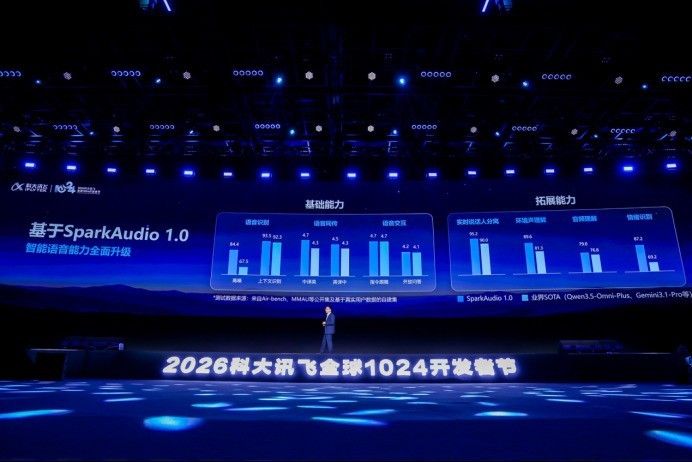
AI 助手究竟该待在哪儿?讯飞给出的答案是把它们从聊天窗口里搬出来,放进眼镜、录音环和汽车座舱。第十届全球 1024 开发者节上,这家公司同时亮出三类贴近日常的终端,支撑它们的是当天登场的 SparkAudio 1.0,一套语音基座大模型。
先看底座。真实环境中的语音交互远比安静房间复杂:展会人声鼎沸,会议室里多人抢话,车内还夹着路噪和音乐。要在这种条件下判断谁在说、说了什么,模型必须同时处理说话人分离、环境声理解与情绪识别。讯飞把这些能力收进同一个底座,并给出一组对比数据:效果提升两成,响应时间缩短一成五,成本下降六成。三个数字来自发布会口径,落到体验上就是听得更准、答得更快、更多设备用得起。
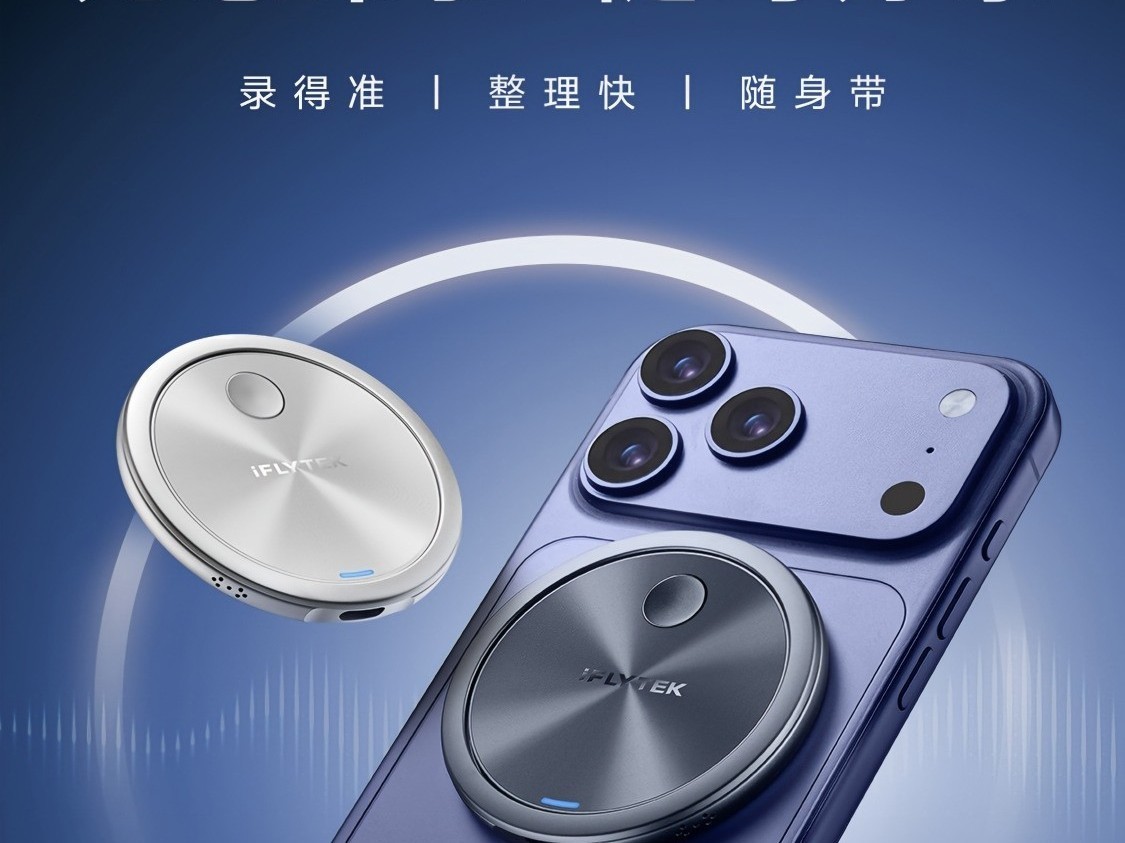
第一款终端是 AI 录音环。整机 35 克,能吸附在手机背面,也能当支架用,按一下便开始收音。它瞄准的是"来不及记录"的瞬间——会议已经开始,人还在翻应用找录音键。官方给出的转写表现是:两小时录音大约两分钟出稿,高噪声场景同样能完成转写。配套的办公本还能把纪要与待办、跟踪系统串接起来,让记录从留下文字走向推动事情。
第二款是 AI 眼镜,重量 40 克。它能做的事包括多语种同传、会议纪要整理、多模态降噪识音,还有依托语义理解实现的智能提词。发言时提示内容会跟随阅读进度滚动,与人交流也不必频繁低头看屏幕。据称生活支付、骑行记录、实时导览、搜索与拍照这些能力也在陆续打通,不过这些属于后续规划,需要与现场已经演示的功能分开看待。
第三块落在车上。星火智慧座舱 3.0 重点放在多人交互与多模态交互,也覆盖复杂智能体任务执行、车外远场识别,按照发布会说法,该方案已在多款车型上量产。车厢里的典型难题是乘客不止一位、声源不止一个、表达未必规范,座舱要更好用,就得适应人的说话方式,而不是让人去记机器的规则。
把三件产品摆在一起,逻辑相当统一:先让机器在嘈杂环境里听清,再把理解结果接到具体任务,最后让交互发生在用户最顺手的位置。AI 硬件的比拼终究不是比谁体内装了大模型,而是比谁能让用户少操作几次、少错过一些信息。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复