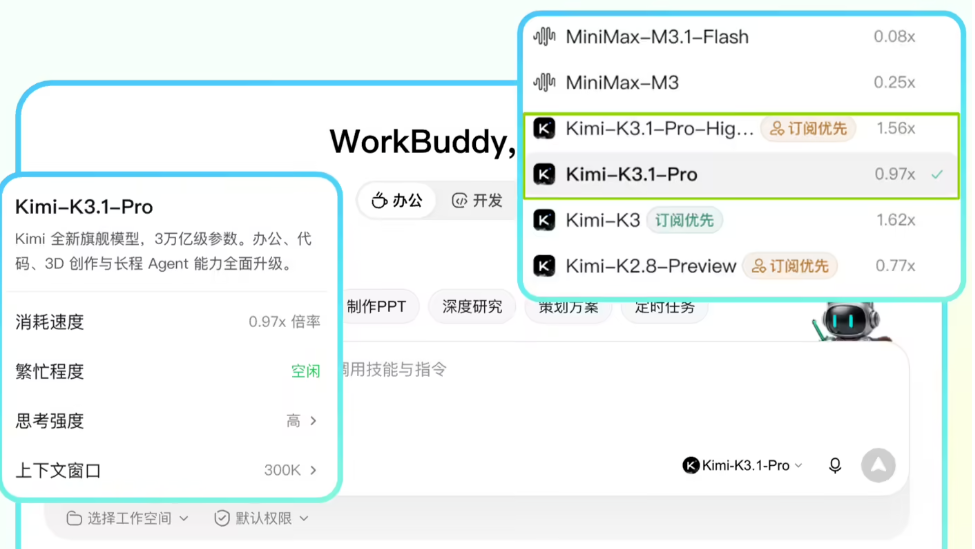
办公类智能体开始比拼模型货架了。10 月 24 日,腾讯旗下 WorkBuddy 宣布接入 Kimi K3.1 Pro,同时上线一个高速版,名叫 Kimi K3.1 Pro Highspeed。
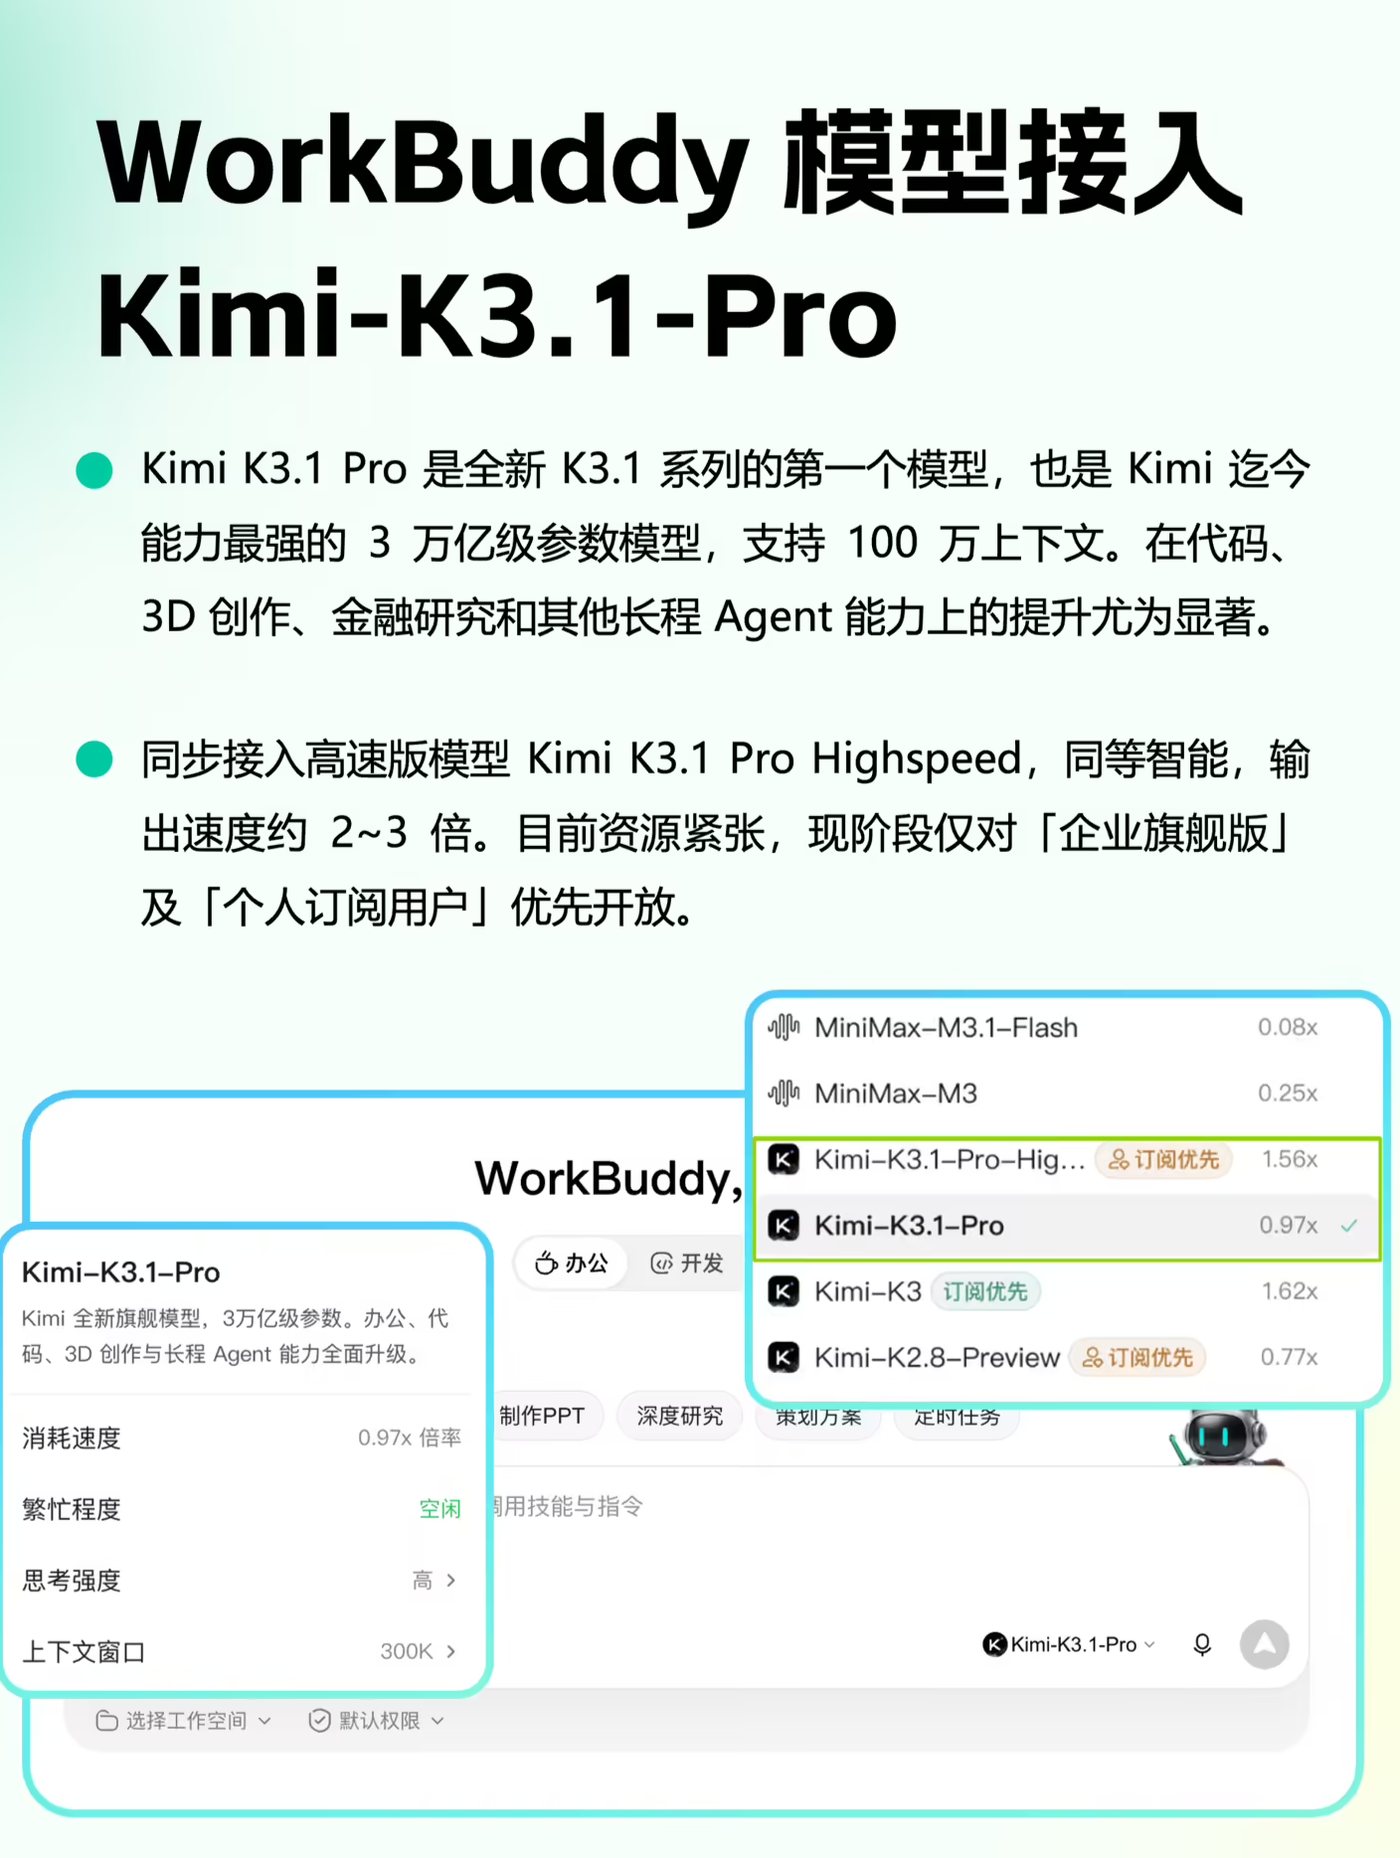
两个版本的分工很清楚:常规版给完整能力,高速版保持同等智能水平,出字速度约为前者两到三倍。官方说明,眼下资源紧张,这阶段只对企业旗舰版与个人订阅用户优先开放。这类灰度策略在模型接入初期很常见——先让付费用户消化算力压力,再逐步放开。
Kimi K3.1 Pro 的分量不轻。它是 K3.1 系列打头的模型,参数规模 3 万亿,能吞下 100 万词元的上下文,也是该团队目前最强的一版。官方强调,代码、3D 创作、金融研究与长程智能体任务是提升最明显的几个方向;研发过程中,强化学习环节吃掉的算力被大幅提高。
基准数据能说明一部分问题。Terminal Bench 4.0 这项测试里,K3.1 Pro 拿到 65.7 分,GPT 6 Astra 是 58.2,Claude Opus 5.5 为 66.4——差距只有 0.7 个百分点。BenchCAD 上它借助工具得到 92.7 分,同样贴着对手:Claude Opus 5.5 是 96.2,GPT 6 Astra 是 95.9。金融相关的两项测试里,它分别拿下 64.4 与 36.3,都是当前最好成绩。
把这些数字翻译成使用场景,大概是这样:长上下文意味着整本手册、整份财报可以直接丢进去,不必反复切片;代码与 3D 创作能力的提升,对应设计、研发类工作流;金融方向两项测试登顶,则直接指向报表核对、数据整理这类高频办公任务。
WorkBuddy 选择在这个时候扩容货架,逻辑不难理解。办公智能体的体验差异,很大程度上取决于背后模型的推理深度与响应速度:复杂任务需要强模型慢慢想,简单任务需要快模型立刻答。标准版与高速版并行,本质是让系统按任务难度自动分流,既控成本也保体验。
对普通用户而言,模型名字可能并不重要,重要的是能不能少改几遍、少等几分钟。这也是这一轮办公智能体竞争的实质——不再比谁的参数更大,而是比谁能把合适的模型放到合适的任务上。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复