9 月 5 日,小米正式发布通用表格数据基础大模型 TabLDM。据介绍,该模型以单一预训练模型、统一默认配置直接适配不同表格数据集,无需针对每个任务重新训练、调参或做后置集成,即可完成分类与回归预测。
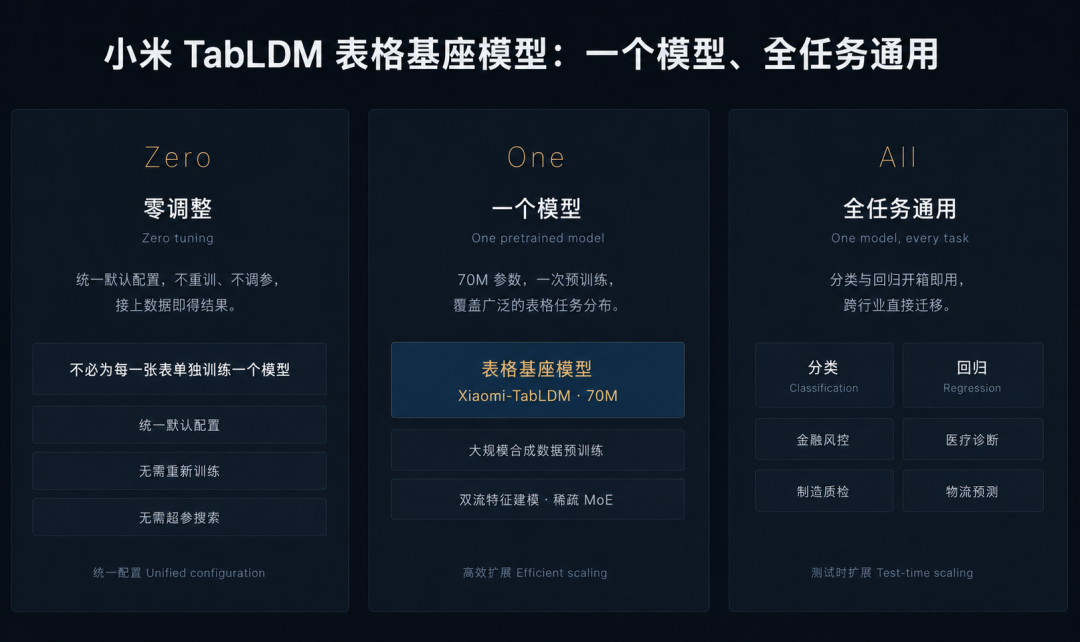
长期以来,金融、医疗、制造、物流等领域大量核心数据以表格形式存在,但传统表格机器学习通常需要针对每一个新数据集重新训练、调参甚至集成模型,存在多次训练及版本管理等繁重的部署代价。TabLDM 的目标,正是把“一次预训练、跨任务使用”的基础模型范式带入结构化数据领域,降低表格 AI 的应用门槛。
该模型从三个方向推进表格基础模型能力。预训练方面,TabLDM 完全基于结构因果模型生成的大规模合成数据进行预训练,覆盖不同数据规模、变量类型、依赖关系和函数关系,从而扩大预训练任务分布。模型架构方面,它引入双流特征分组、轻量级注意力残差和稀疏混合专家等设计,从不同粒度建模特征关系,通过稀疏专家扩大模型容量。推理方面,该模型进一步探索了测试时扩展技术,在保持预训练模型参数不变的情况下,通过增加推理阶段计算量持续提升预测性能。
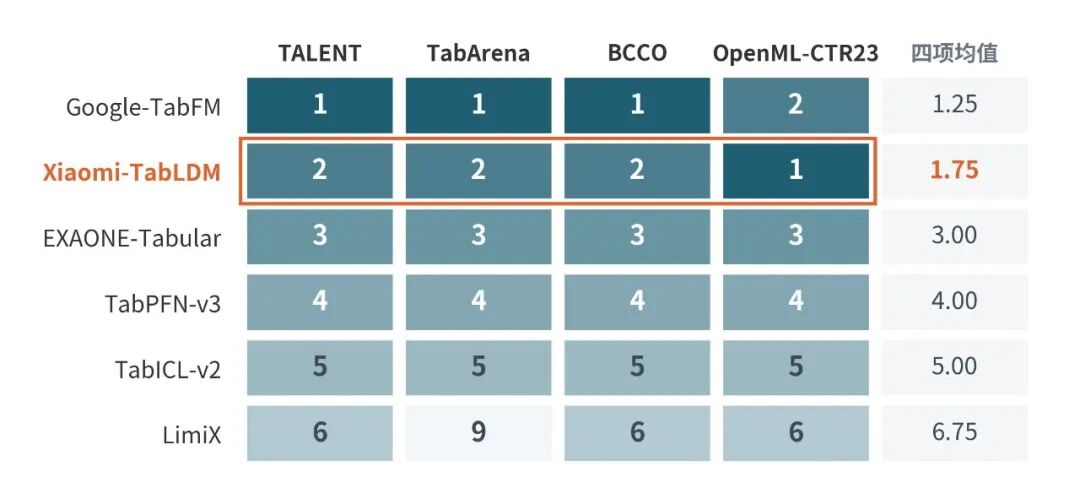
在四大公开基准评测中,TabLDM 均跻身第一梯队。回归能力表现尤为突出:在回归基准榜单上排名第一;在 TALENT、TabArena 和 BCCO 的回归任务中均排名第二;在 TALENT 二分类任务中同样排名第一。在性能与效率的平衡上,以 TabArena 回归任务为例,TabLDM 取得第二高的评分,同时训练时间比排名第一的模型减少 82%,预测时间减少 68%。
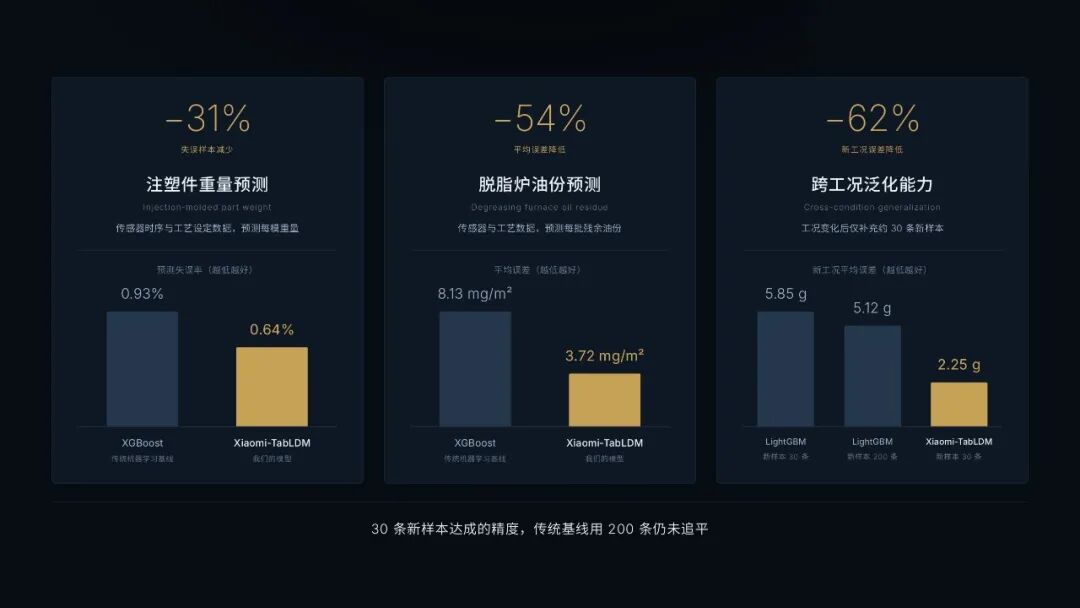
在真实工业场景验证中,TabLDM 相比传统机器学习展现出更高的预测精度和跨工况适应能力。材料性能预测场景下,该模型无需微调即可将预测精度提升 130%,减少约 90% 的无效试模与装机测试;零件重量预测场景中,相比 XGBoost,失误样本比例降低约 31%;生产组分预测场景中,平均误差相比 XGBoost 降低约 54%;当生产工况发生变化时,仅补充约 30 条新工况样本作为上下文,即可将平均误差再降低约 62%。
该模型提供 sklearn 兼容接口,可通过 pip 安装使用。目前,TabLDM 相关模型权重与代码已正式开源,技术报告同步公开,开发者可以下载模型、复现实验,并在此基础上针对自身业务数据进行二次开发。
从行业视角看,表格数据仍是企业数据资产中占比极高的部分,通用表格大模型的出现,有望把“训练一次、处处可用”的范式复制到结构化数据世界,让制造业质检、供应链预测、金融风控等场景直接受益。小米此次选择开源路线,也有助于吸引更多研究力量共同完善表格基础模型生态。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复