XHEART新芯航途在10月29日把大模型芯片X7 Ultra推到了台前,主打“用大模型定义芯片”,从量产模型的真实需求反推架构设计,大模型算力达到700 TOPS。
公司首席执行官李宗霖的逻辑是:智能驾驶从一堆小模型拼接转向端到端大模型,芯片该怎么设计自然要跟着换。新芯航途2023年创业时就定了这条路线:先看模型要什么,再重新组织计算、存储与数据流转,并为后续模型演进留出余量。
按官方说法,X7 Ultra在量产模型上的实测对齐度达到99.99%。NPU用的是超大核结构,数据在核内互通,比起跨核搬运,速率直接拉到每秒太字节的量级;多级缓存架构支持大容量与高并发,目的是压低推理时延与功耗。
算子层面,这枚芯片内置高精度大模型专用加速引擎,把Softmax、Layernorm与Transpose这类Transformer里绕不开的算子逐一做了硬件优化,原生支持半精度与单精度浮点向量计算,以保证模型精度不掉点。
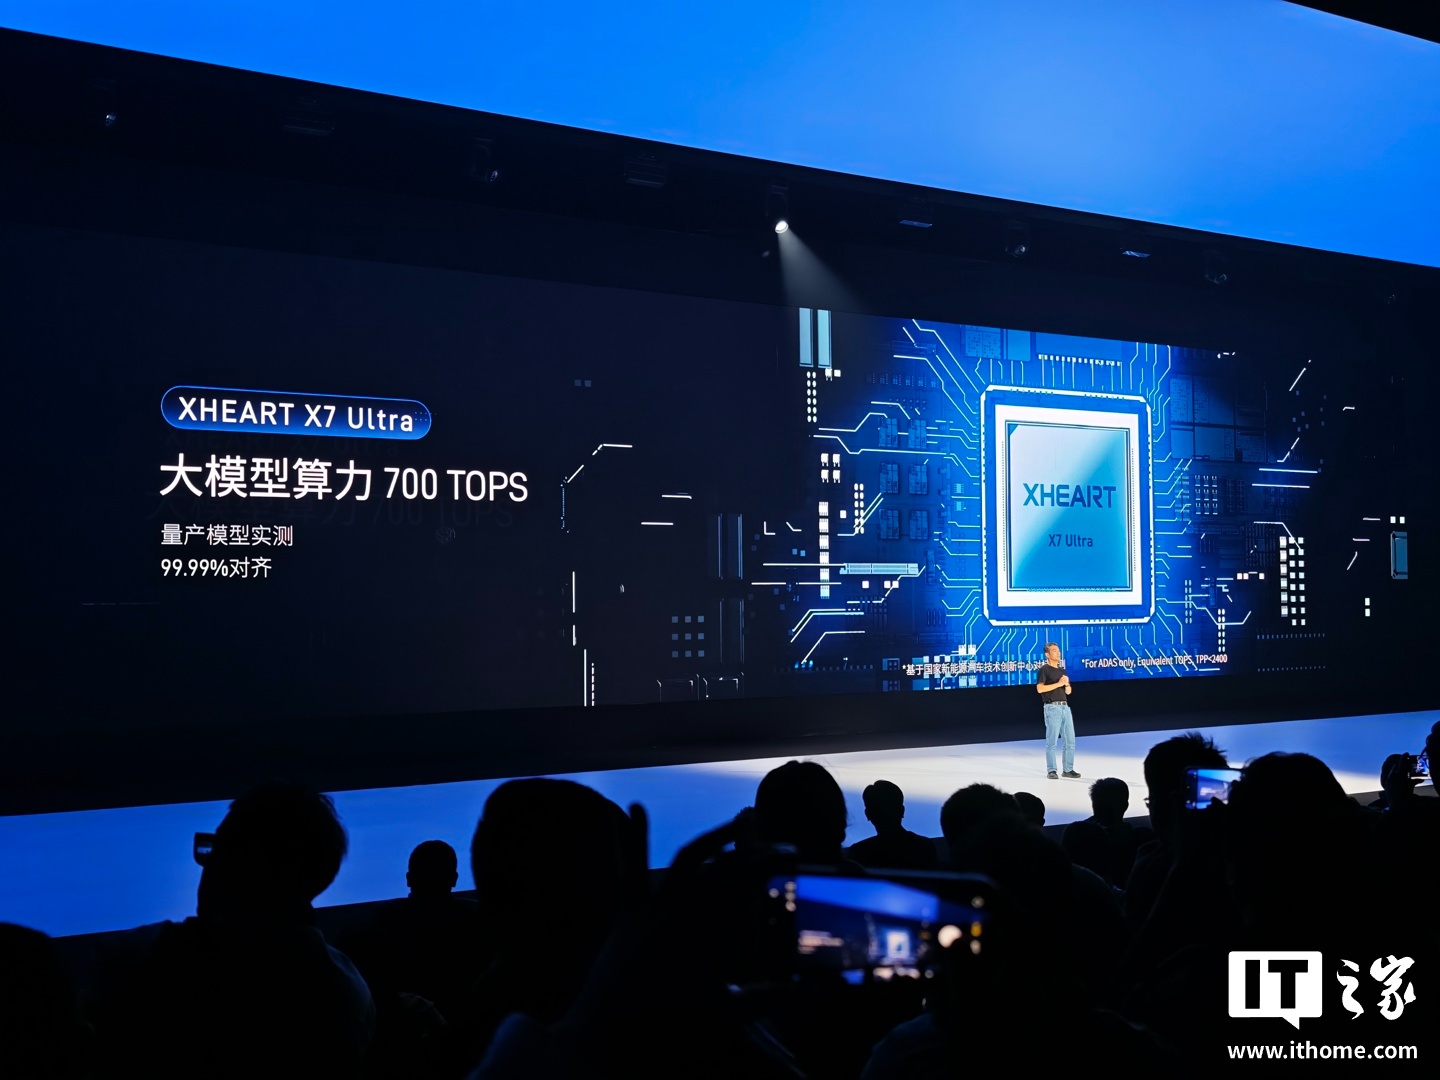
官方给出的效率数据是:NPU硬件并行度充分释放后,计算利用率达到98.7%;相比行业旗舰产品,内存带宽省下八成,能效翻了一倍。
CPU部分同样值得注意。X7 Ultra的CPU是中国头一个量产上车的Armv9车规方案,性能涨两成、能效涨一成;大集群架构改善了多核协同与L3访存性能,还塞进新的SVE2向量引擎,DSP表现比上一代NEON更硬。
把参数翻译成体验,端到端大模型上车最怕两件事:一是算力不够导致推理降频,二是带宽吃紧让多路摄像头数据排队。核内互联与缓存的调整,针对的正是这两个瓶颈。
真正的考验在量产落地。芯片的纸面算力容易比较,难的是在不同车企的模型、传感器配置与散热条件下保持一致表现。X7 Ultra能否把99.99%的对齐度复制到实车上,要看接下来一两个车型周期的验证。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复