9月1日,亮源新创(LightOrigins)在深圳发布并开源通用导航大脑LightNav 0,这一模型在公开的视觉语言导航(VLN)评测基准上取得全面领先成绩。团队介绍,基于自研的Real2Sim2Real技术,他们利用2000多个真实室内外场景,大规模合成了超过4000小时的训练数据,使同一套模型无需目标机器人、目标环境或特定任务的训练数据,也不必额外微调,即可零样本迁移到不同机器人本体与全新真实环境中执行自然语言导航任务。
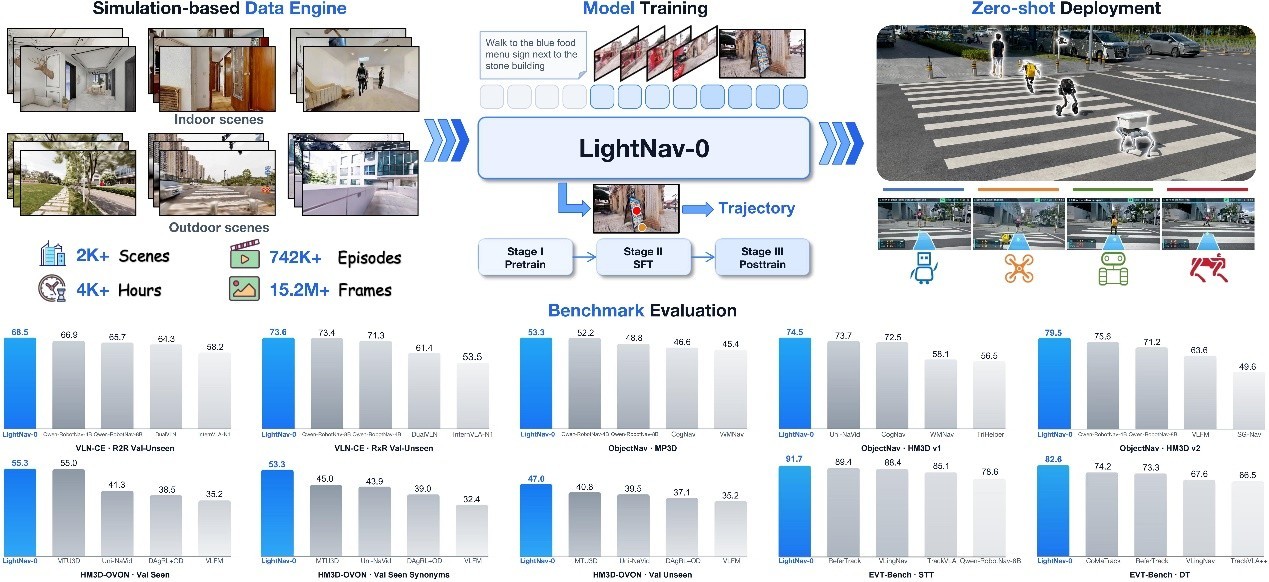
视觉语言导航要求机器人理解自然语言指令,并在持续感知环境的过程中完成空间推理、行动决策与导航控制。对模型而言,更换机器人、更换环境、更换任务类型都是对泛化能力的直接考验。此次LightNav 0验证的零样本能力覆盖跨本体、跨任务、跨场景三个维度,即模型部署到新机器人、新场景或新任务时,无需重新收集数据与微调。
LightNav 0是亮源新创规模化预训练、规模化对齐、规模化部署三段范式下,规模化对齐环节的代表性成果。真实机器人数据最贴近部署环境,但规模化采集困难、多样性有限,因此团队把真实空间转化为可重复使用的仿真资产,用全自动数据合成管线批量生成机器人运动轨迹与自然语言指令,再用于监督微调与强化学习训练。
沿着真实世界定义分布边界、仿真规模化合成分布内数据的路径,团队形成了完整的数据飞轮:部署中发现的新场景、新任务与失败模式会回流为仿真资产与训练任务,规模化产出针对性数据,更新后的模型再回到真实世界接受检验,从而形成真实问题持续回流、训练数据持续积累、模型能力持续提升的闭环。
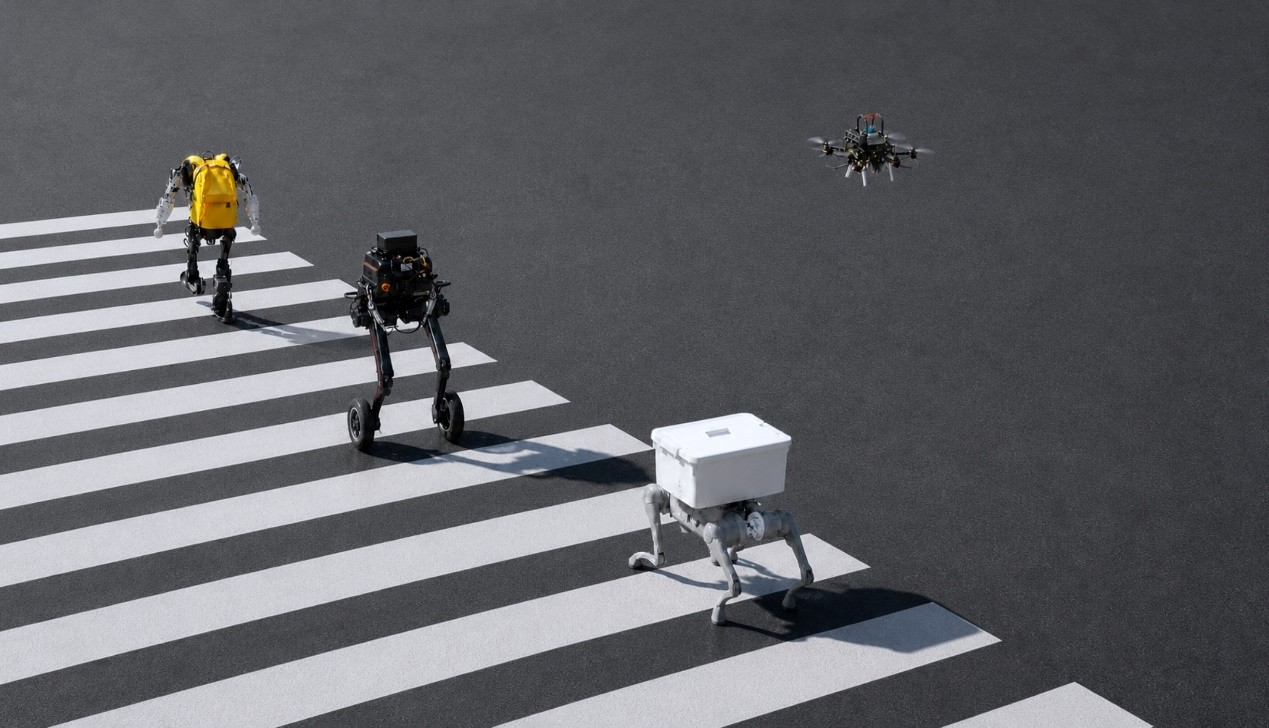
亮源新创表示,公开榜单成绩还不能完全回答模型在真实世界是否好用的问题,后续将开放一套更贴近真实使用体验的VLN评测体系,在现有基准之上覆盖多种机器人本体、真实室内外环境、更复杂的语言指令与长程任务等维度,也欢迎开发者在更多机器人、场景与任务中复现检验这一开源模型。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复