国际权威AI安全评测CyberGym最新榜单显示,深信服AI安全智能体以93.2%的综合成功率强势登顶全球第一,超越OpenAI、Anthropic、Meta等国际AI巨头。该成绩基于纯国产基座模型与固定配置实现,使深信服成为榜单前十中唯一以国产技术栈参赛的厂商。
CyberGym是由加州大学伯克利分校于2025年6月发布的AI智能体网络安全评测基准,被公认为当前全球规模最大、最贴近真实工业防御场景的AI安全"实战靶场"之一。与传统的静态理论题评测不同,CyberGym模拟真实攻击链与防御环境,让AI智能体在动态对抗中完成漏洞挖掘、渗透测试与安全加固等任务。
换言之,CyberGym榜单衡量的是AI安全智能体"真刀真枪"解决真实漏洞的能力,而非纸面分数。这使得榜首头衔在行业内具有极高的公信力,也意味着参评厂商必须在实战能力上拿出真本事。
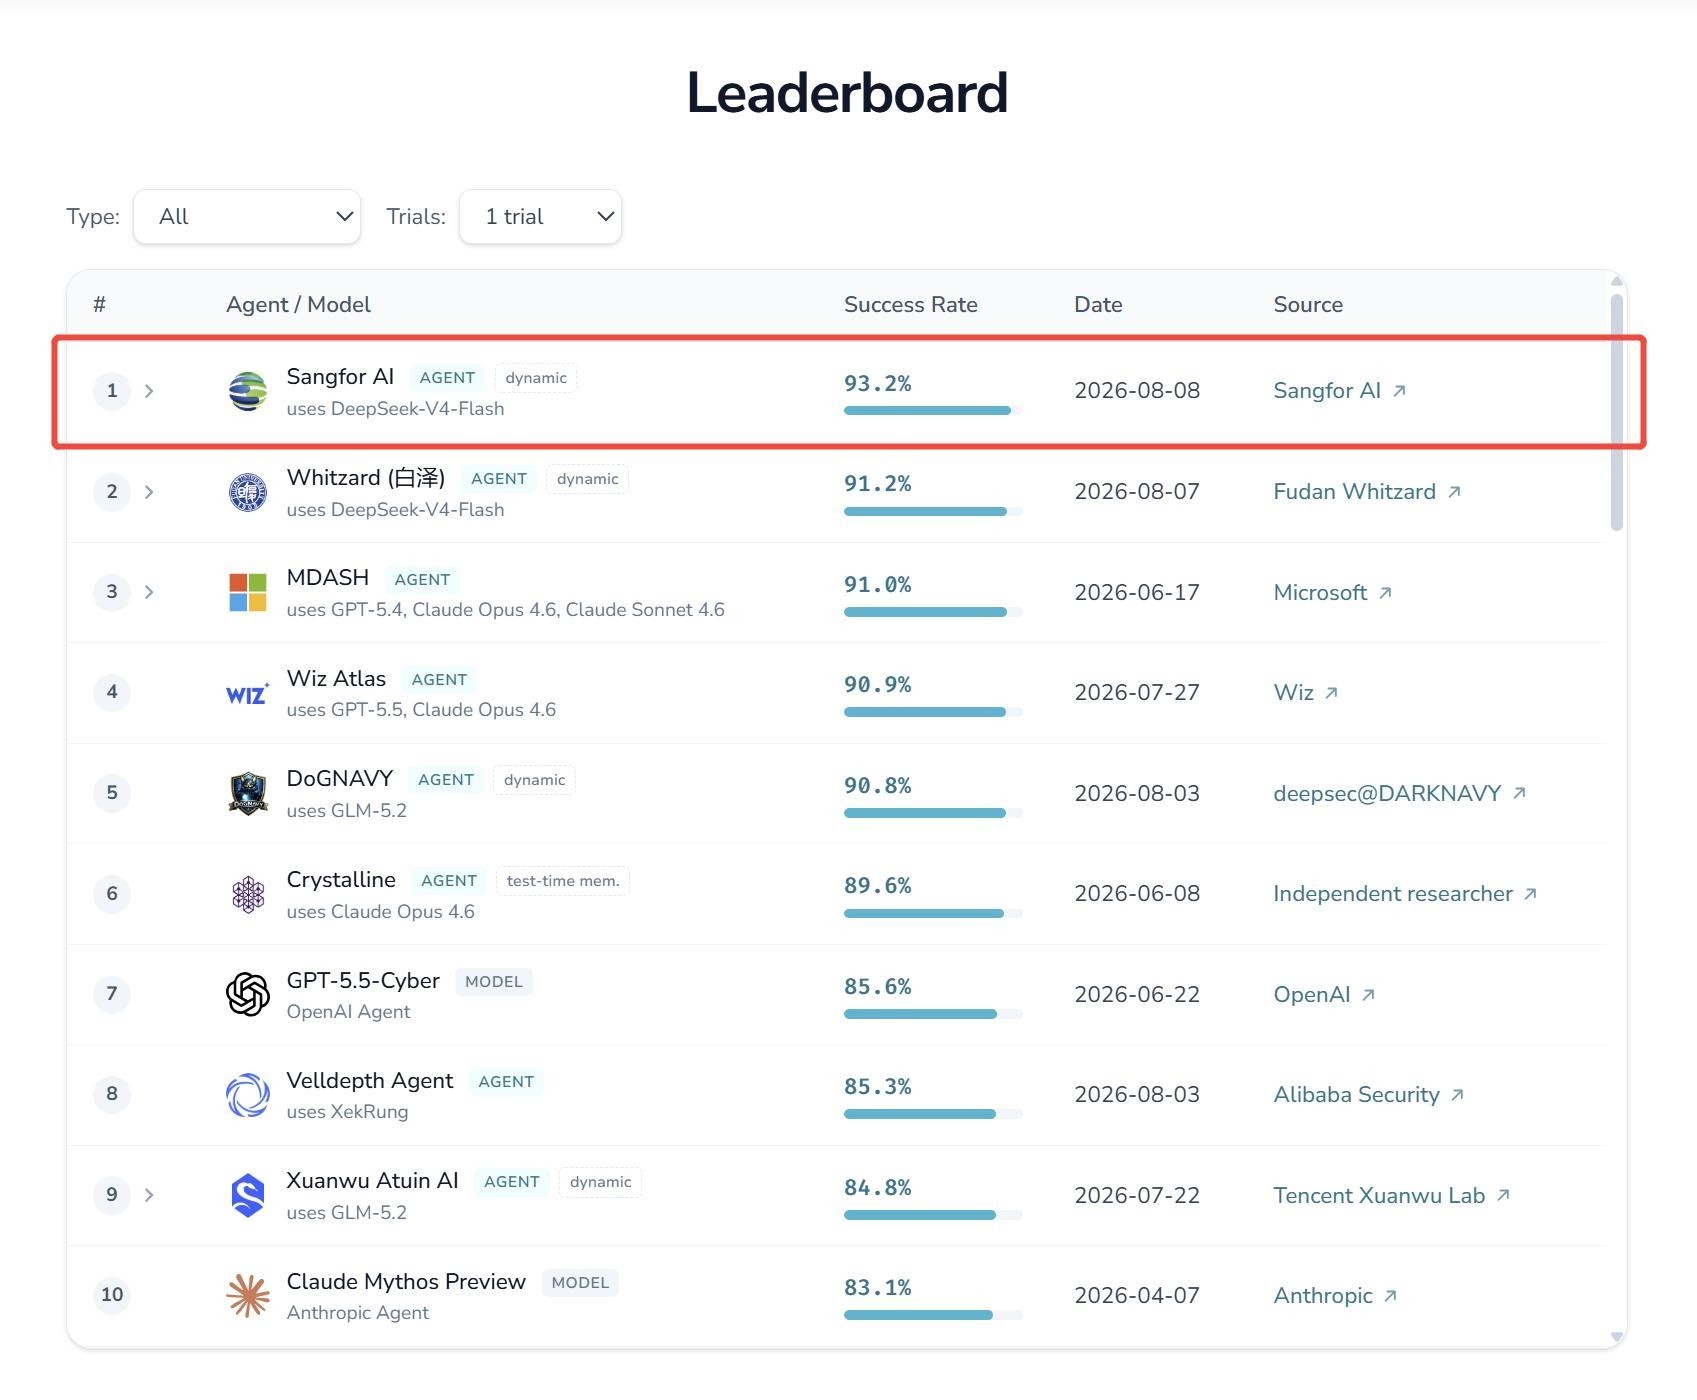
在与OpenAI、Anthropic、Meta等全球头部厂商的同场竞技中,深信服AI安全智能体交出了完整、公开且经得起严格验证的实战答卷:综合成功率93.2%,位居CyberGym全球第一;ARVO来源任务成功率93.13%;OSS-Fuzz来源任务成功率93.53%。在细分维度上,两项高难度漏洞集任务的成功率均保持在93%以上,说明其能力并非依赖单一场景的偶然发挥,而是具备可复现、可验证的体系化安全推理能力。
比名次更值得拆解的,是成绩背后的技术路径。深信服没有把赌注押在更强的单点模型上,而是聚焦于一个更核心的问题——如何让大模型的安全推理过程可信、可验证。大模型做漏洞挖掘的普遍痛点,在于推理难以溯源:多个假设相互干扰、错误路径被反复重试、结论缺乏可验证依据。
深信服的应对方案,是构建一套"智能体群体(Agent Swarm)协同作战"架构,核心是以"证据"为线索的推理治理:有界探索方面,围绕不同安全假设开启独立、边界清晰的调查分支,避免多个假设互相污染;证据链管理方面,为每一步推理建立可追溯的证据链条,结论必须附着可验证的事实依据,杜绝凭空猜测;协同分工方面,多个智能体分别承担侦查、分析、验证与利用等角色,通过任务分解与结果互检提升整体成功率。
这种"多智能体协同+证据驱动"的架构,让AI安全能力从"单点模型聪明"升级为"体系作战可靠"。随着大模型在安全攻防中的应用深入,可解释、可验证的安全推理正成为衡量AI安全厂商真实水平的关键标尺,深信服此次登顶也为国产AI安全技术在国际权威评测中树立了新的标杆。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复