腾讯混元在 10 月 26 日发布并开源了同声传译模型 Hy SimulMT。它的定位很明确:中英之间的语音到语音实时翻译,说话人的音频实时输入,模型边听边译,直接给出译文与语音,同时支持实时音色克隆,尽量还原说话人的声音和语气。
这项能力已经在腾讯 Hy 翻译 App 上首发,用户可以免费体验。对一款同传产品来说,免费开放意味着它要直接面对真实场景的嘈杂环境、口音差异与专业术语,而不是实验室里的干净音频。
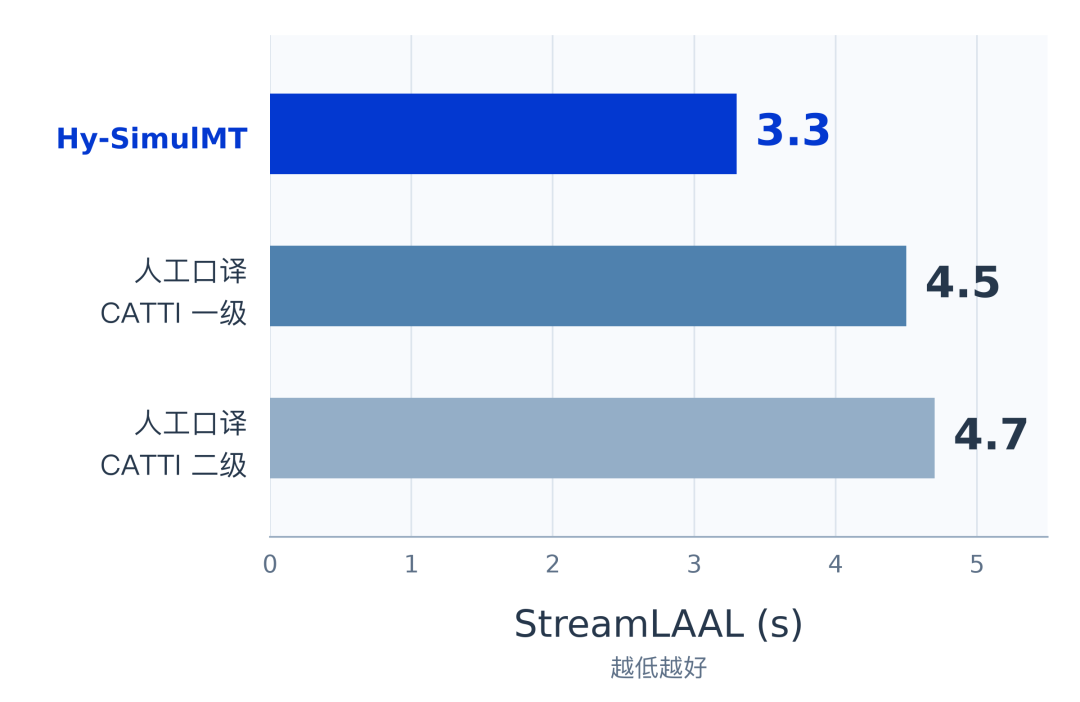
低时延是官方强调的核心指标。实测响应时间在 3 秒左右,而人类专业译员的平均水平是 4 到 5 秒。这个差距放在会议场景里很关键:延迟越低,听众的等待感越弱,翻译与讲话人的节奏越容易对齐。
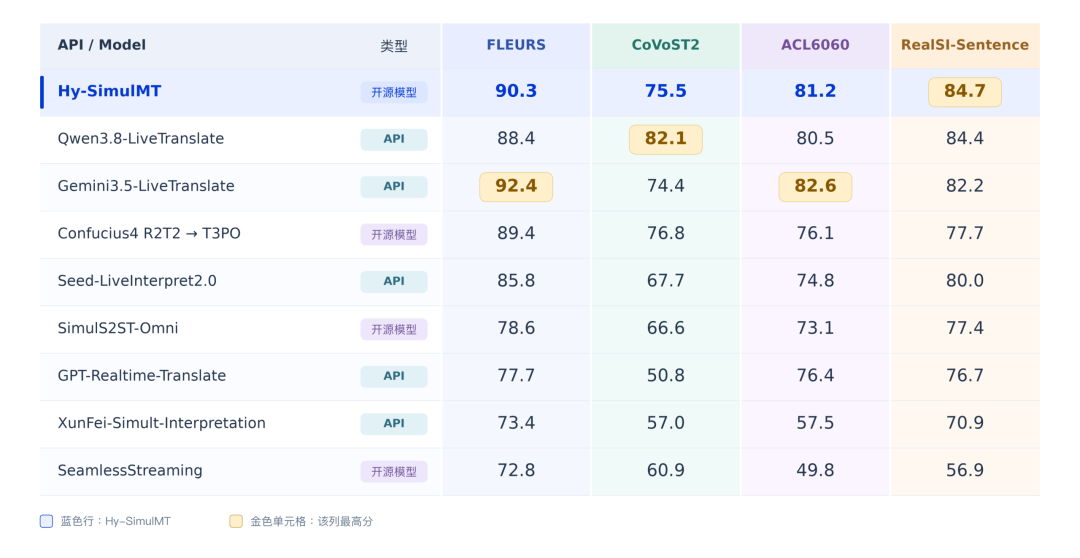
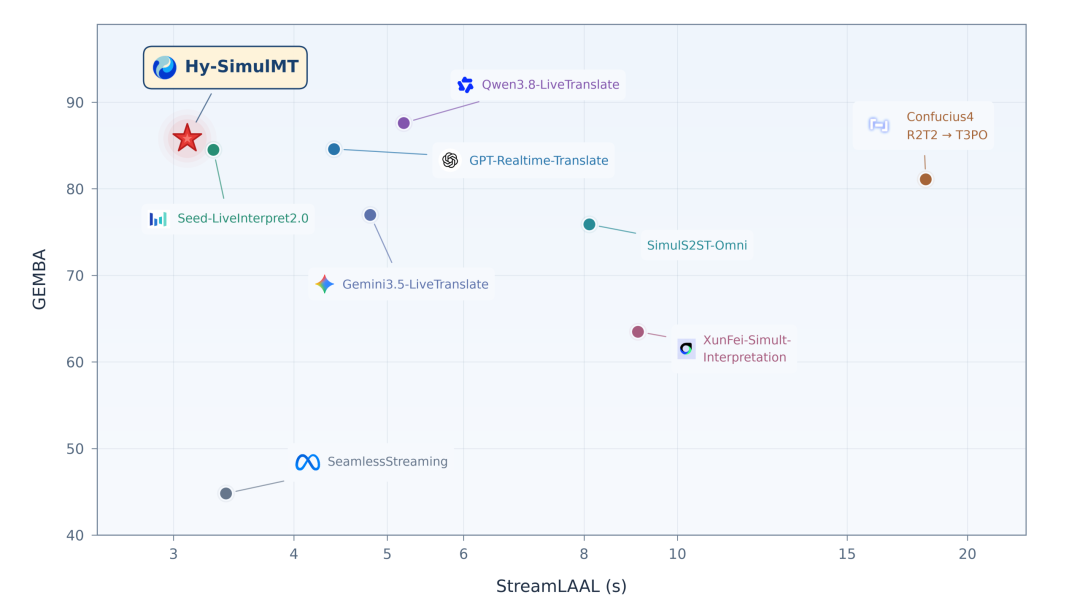
测评方面,官方称其效果压过多数开源同传方案,也超过不少商业接口。长音频评测集 RealSI 是业界常用的一组测试,横轴 StreamLAAL 衡量译文比原声慢多少秒,数值越低越好;纵轴是翻译质量,由 GPT6.1 Sol 打分,越高越好。官方给出的曲线显示,Hy SimulMT 在延迟最低的情况下拿到了开源模型里最好的效果。
短音频测试集上也有相应表现。为了更贴近真实水平,团队在合规范围内收集了互联网上新出现的中英文音频,横跨十个领域:从软件与 AI 到医学、法律、教育,再到制造能源、农业食品、商务管理、文化文旅与体育生活,包含演讲、访谈、会议等场景。
更有说服力的是人机对比:团队请了 6 位人类同传专家,其中 3 位持有一级口译证书,3 位持有二级口译证书,均有多年实战经验。测评把模型与专家的译文在延迟和质量两个维度对比,专家侧取三人中的最高分。结果显示,Hy SimulMT 的翻译质量达到人类专家水平且得分更高,速度也更快。
从技术路线看,语音到语音的同传比文本同传难得多:模型要在没有完整句子的情况下判断语义,还要同步生成语音,任何迟疑都会累积成明显延迟。音色克隆则进一步要求模型保留说话人的音色特征,同时不牺牲清晰度。
这类模型的实际价值,短期内更多体现在会议、直播、跨境客服与旅行场景。它不会立刻取代专业译员,但能把基础沟通的成本压到很低,让原本请不起同传的场合也能用上实时翻译。
开源之后,真正的影响取决于生态。如果开发者能基于它做出垂直场景的定制版本,比如医疗问诊、法律咨询或课堂翻译,同传能力的普及速度会比单纯做一个 App 快得多。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复