大模型到底被用了多少,中国信通院给出了一组可量化的答案:到 2026 年 6 月,全国每天消耗的词元约为 500 万亿个,是 2025 年 12 月的近四倍。
这组数字背后是服务模式的迁移。模型技术快速迭代,词元服务成了技术走向应用的关键环节,越来越多模型即服务平台厂商改用公有云接口供给词元。可用户对服务性能缺少直观判断依据,选型时容易陷进参数迷雾。
为此,信通院人工智能研究所牵头,联合大模型评测重点实验室与人工智能产业发展联盟,发布了 2026 年版《大模型词元服务性能监测报告》。监测从 2025 年启动,本次基于 2026 年 1 至 8 月的数据,从成功率、吞吐、首词时延、稳定性、价格到上下文窗口,逐项对比原厂平台与四款开源模型(DeepSeek、通义千问、GLM、Kimi)在第三方平台的表现。
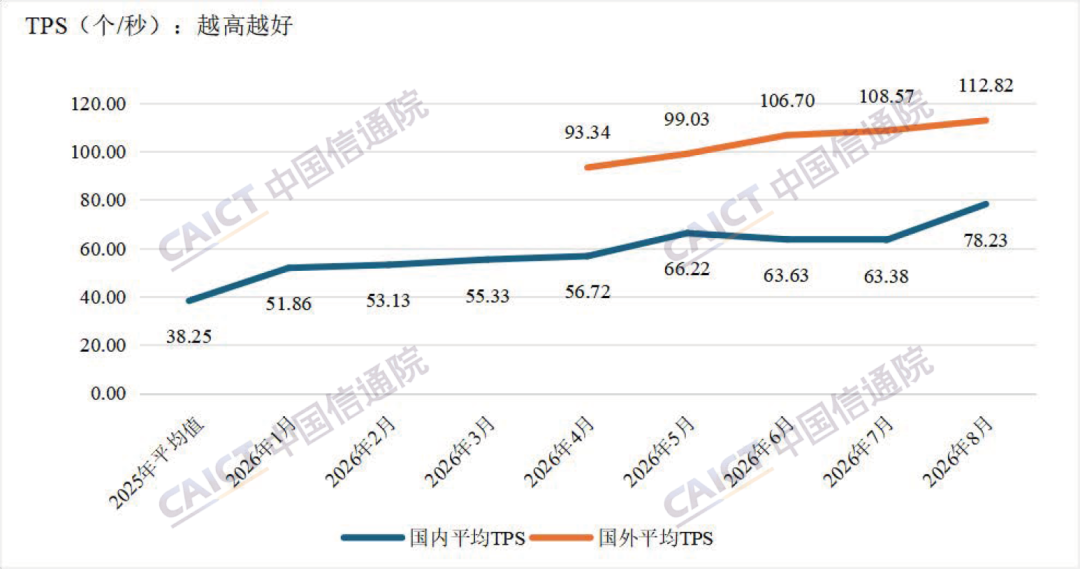
第一项观察是速度。8 月国内各模型平均每秒输出 78.23 个词元,2025 年的均值只有 38.25,一年翻倍。但国外典型模型 8 月的均值达到 112.82,去年 12 月是 51.35,同样翻倍有余,整体仍领先国内。差距没有缩小,只是双方都在加速。
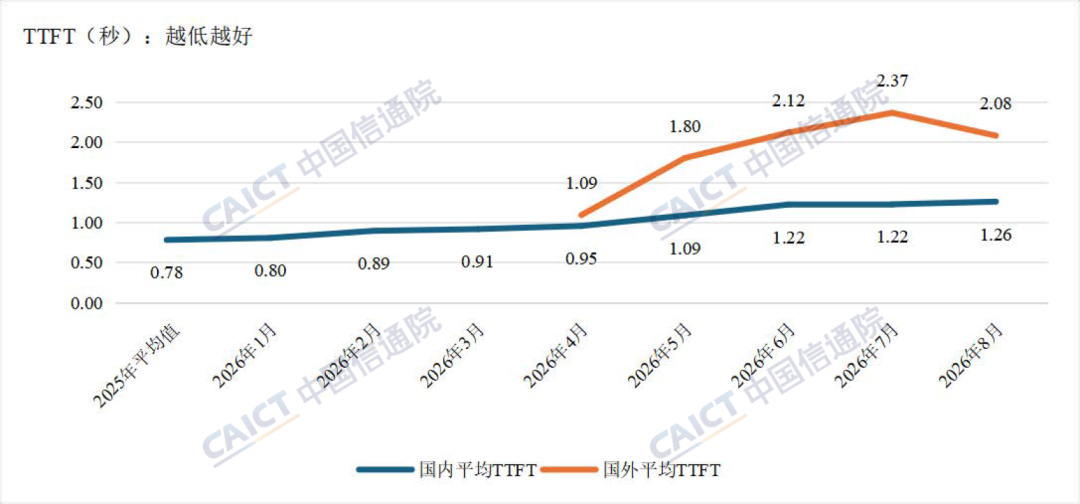
第二项是时延。国内首词时延今年以来一路走高,8 月均值 1.26 秒,高于 2025 年的 0.78 秒;国外典型模型 8 月均值 2.08 秒,而 4 月还是 1.04 秒。报告提醒,这项指标上升并非单纯退化,参数量变大、上下文变长、调用量攀升,都会推高首字等待时间。
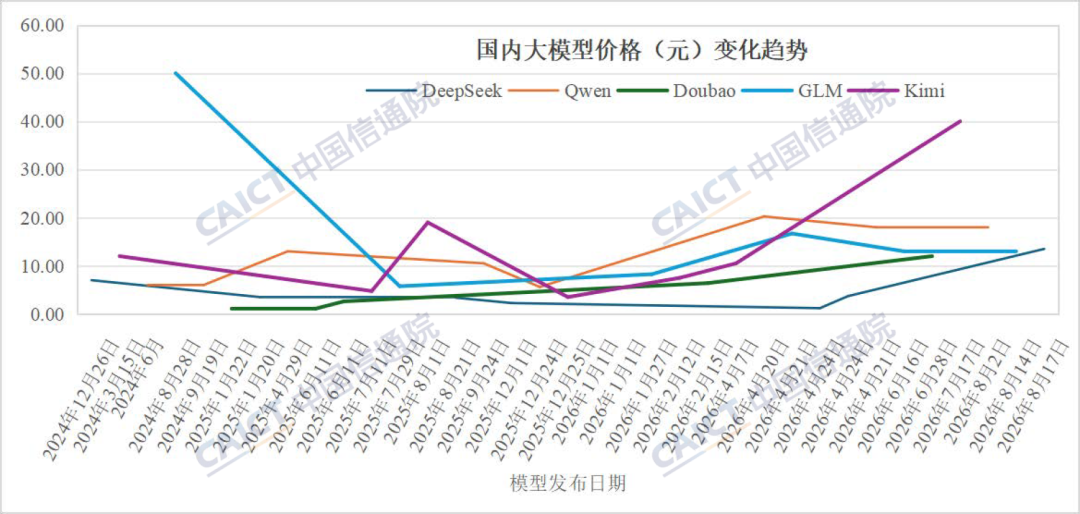
第三项是价格。打完两年价格战,2026 年国内外服务价格明显回升。国内归一化均价从 2025 年下半年的 6.8 元涨到今年的 13.46 元,接近翻倍;国外更贵,今年发布的典型模型平均归一价格约 117.8 元。
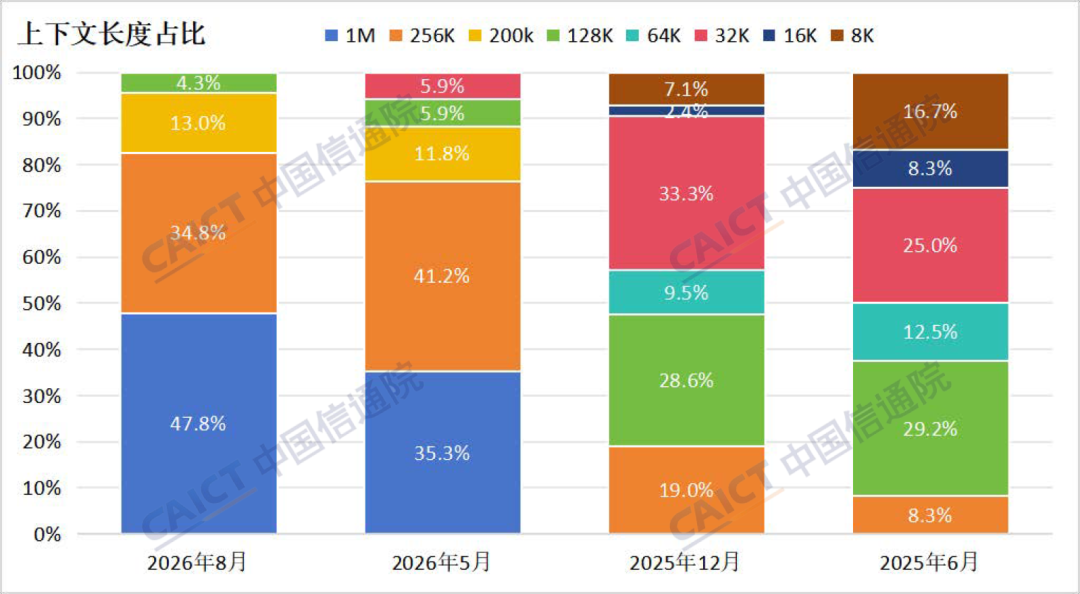
第四项是上下文长度。被监测的模型里,能处理 100 万词元的占 47.8%,20 万及以上的合计 95.7%,比 2025 年底提高超过 76 个百分点,低于 20 万的越来越少。长上下文从卖点变成标配,只用了两年。
第五项关于开源模型。5 月更新四个开源模型的新版本后,吞吐持续提升、时延不断压缩,8 月 DeepSeek V4 Pro 的吞吐已是 V3.2 的两倍。换代初期时延普遍阶段性上升,随着推理优化落地又逐步回落。报告还指出,同一模型在不同平台的表现差异明显,部分第三方平台甚至优于官方,吞吐差距最大接近一倍,根源在于各家的推理加速、优化策略与成本控制不同。
把这些观察串起来,会得到一个朴素的结论:模型能力趋同之后,服务层的工程能力正在成为差异化来源。对用户来说,选型只盯参数已经不够,吞吐、时延、稳定性与价格构成的综合成本,才真正决定体验。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复