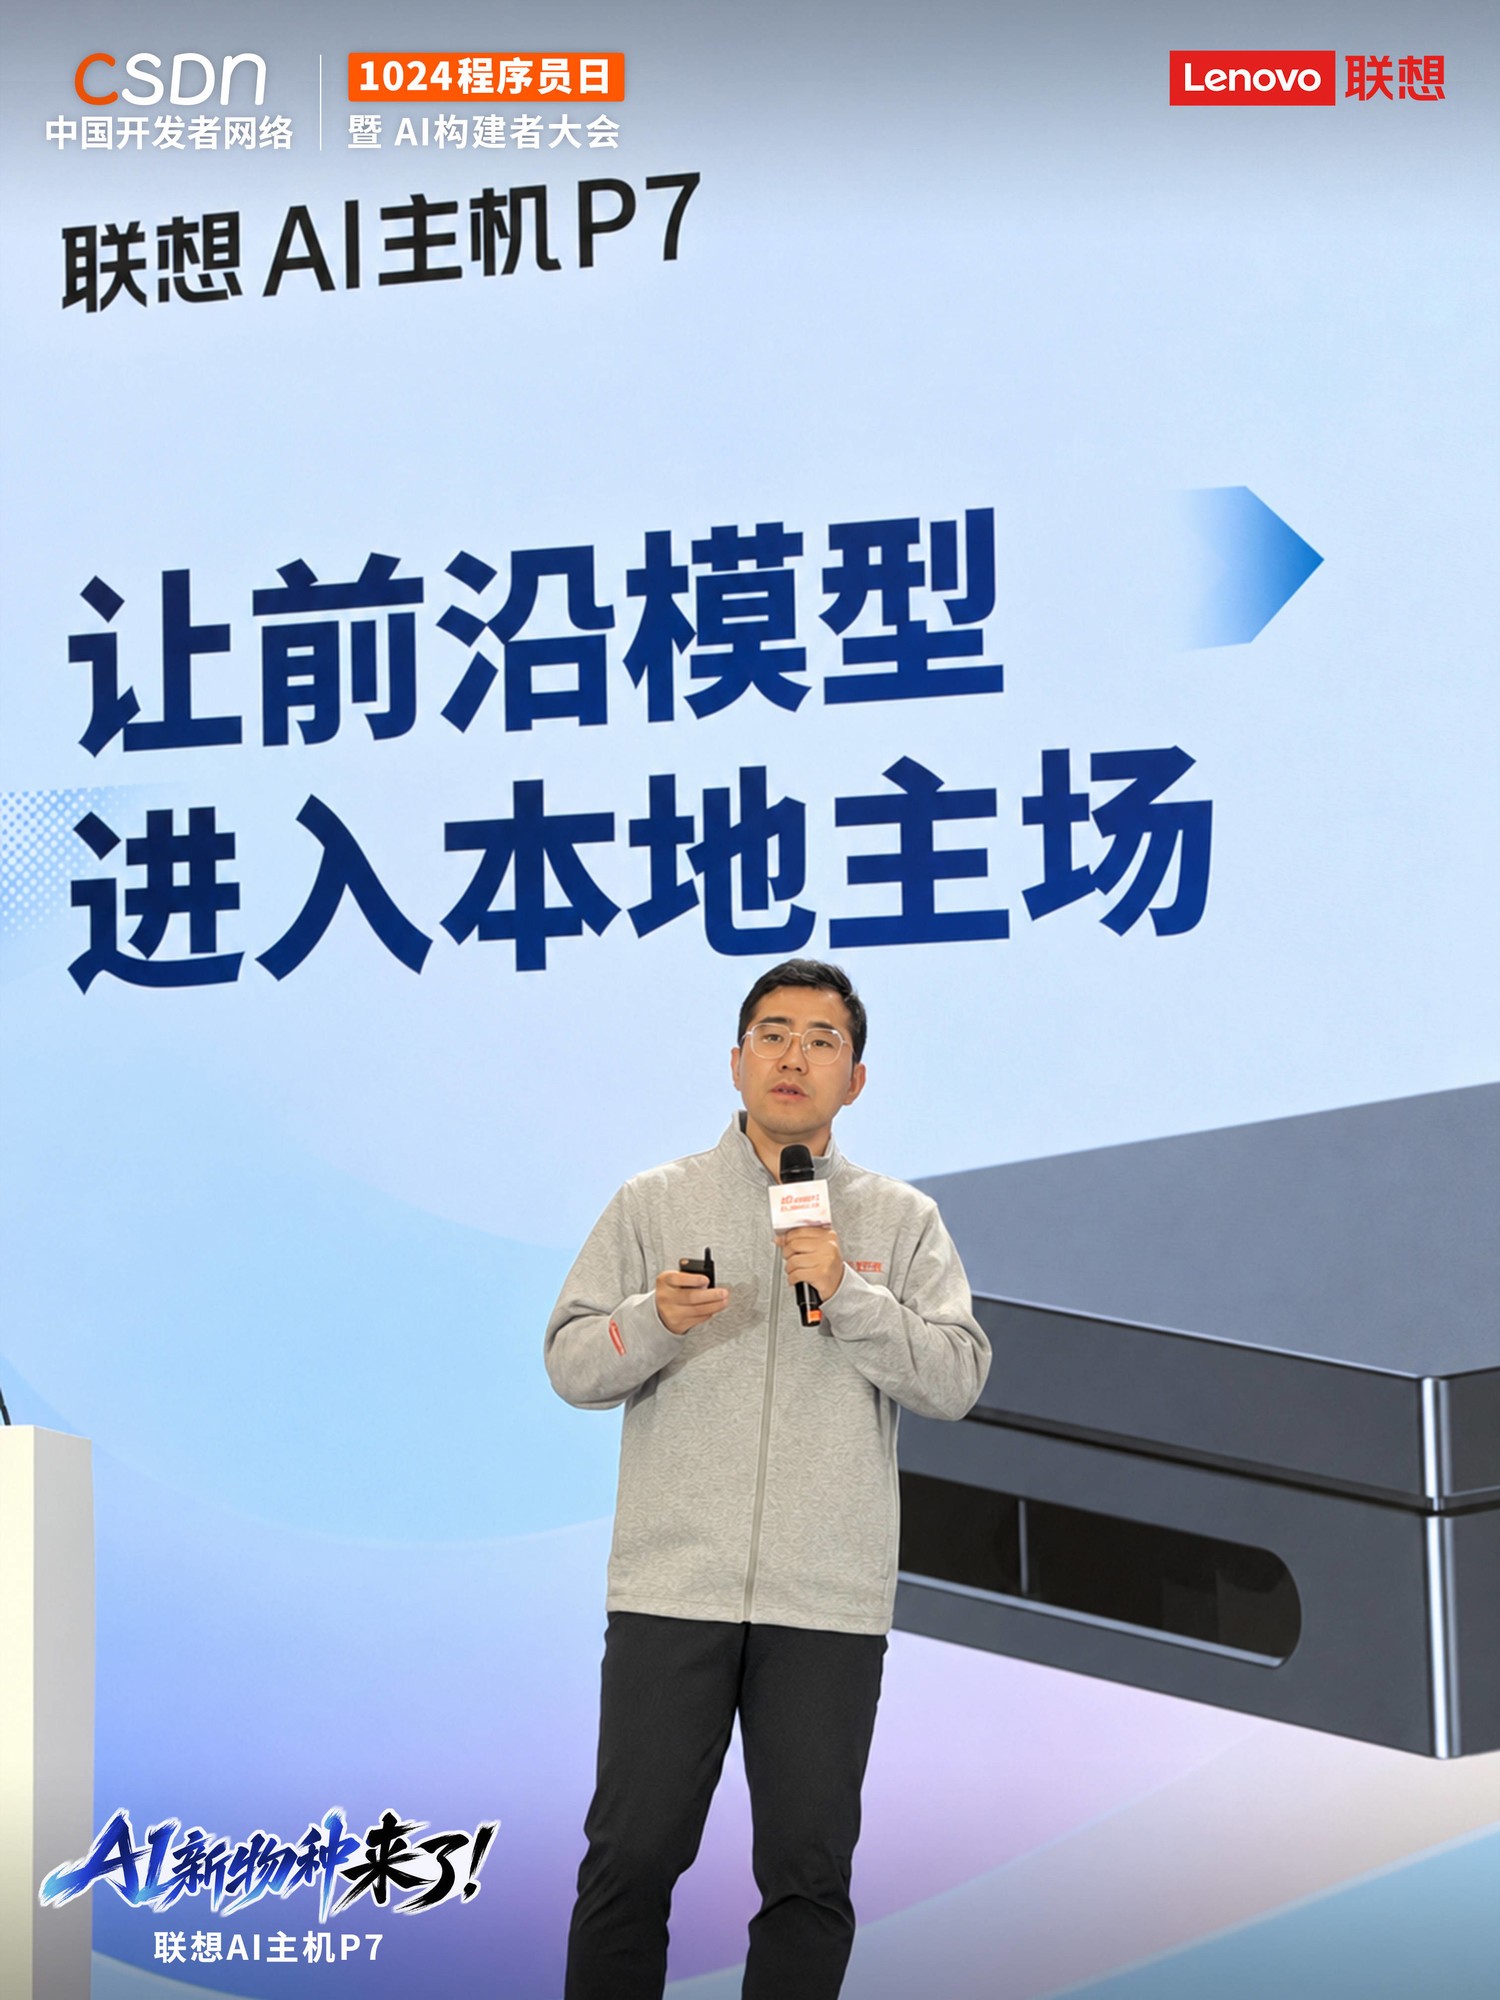
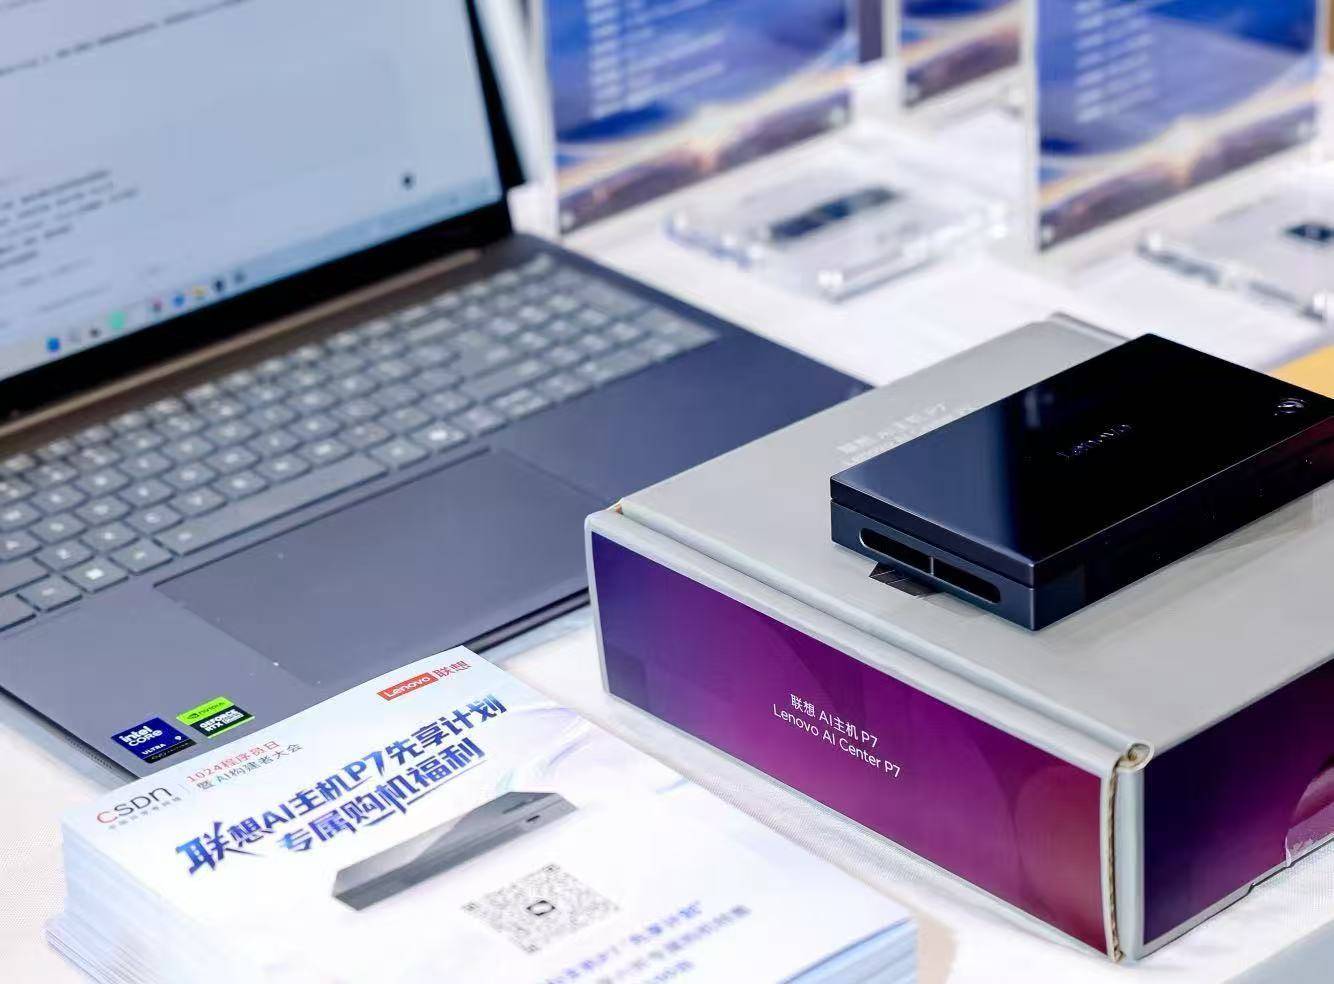
把千亿级参数的大模型塞进一台巴掌大的设备,这是联想 AI 主机 P7 预览版给出的命题。随着软硬件开发收尾、功能趋于完备,这款产品在正式开售前先启动了"先享计划",请第一批用户在实际的编程、办公环境里试用、反馈。
思路来自一份白皮书。白皮书在 9 月 10 日由联想与 IDC 联手推出,里面的提法是"面向大模型与智能体的原生设备"这一概念。它针对的是三重现实顾虑:成本上,词元额度与费用要反复权衡,高强度使用开销长期使用者开支不小;安全上,推理记录与执行日志都托管在云端,隐私缺保障;效率上,智能体不够稳定,长任务还要顾及额度、网络与服务状态,容易被休眠打断。
P7 的回应可以压缩成三句:本地词元无限供给,压低云端的钱;重要数据不外流,权限攥在用户手里;己掌控;24 小时持续推进任务,本地与云端模型智能调度。产品负责人孙科的说法更直接——他原话的意思很直接:动手之前先算一遍账,那算不上生产力前先算一遍词元成本。
第一块能力是词元自由。机身内置本地模型矩阵:通义千问 3.8 系列的 Flash Next 与 27B 版本、3.6 系列的 35B 混合专家版本,另有图像设计、文档识别、语音识别与语音合成方向的专用模型。用户通过词元管理器配置接口与地址,就能把本地模型接进各类编程工具或智能体应用,在模型管理页启停切换,在数据看板看资源占用与任务进度。开发高频迭代时,模型调用尽量走本地,开支自然降下来。
第二块是全天候执行。任务模式支持长周期推进,客户资料、经营数据与内部方案都在机器里处理,不上云;手机、平板、PC 可以跨端查看进度与结果。学习与科研同样受益:课堂资料整理、薄弱知识点反复练、文献梳理与论证核查,以及项目搭建、数据处理、实验运行到结果归档,这些重复又耗时的环节都能被持续接管。
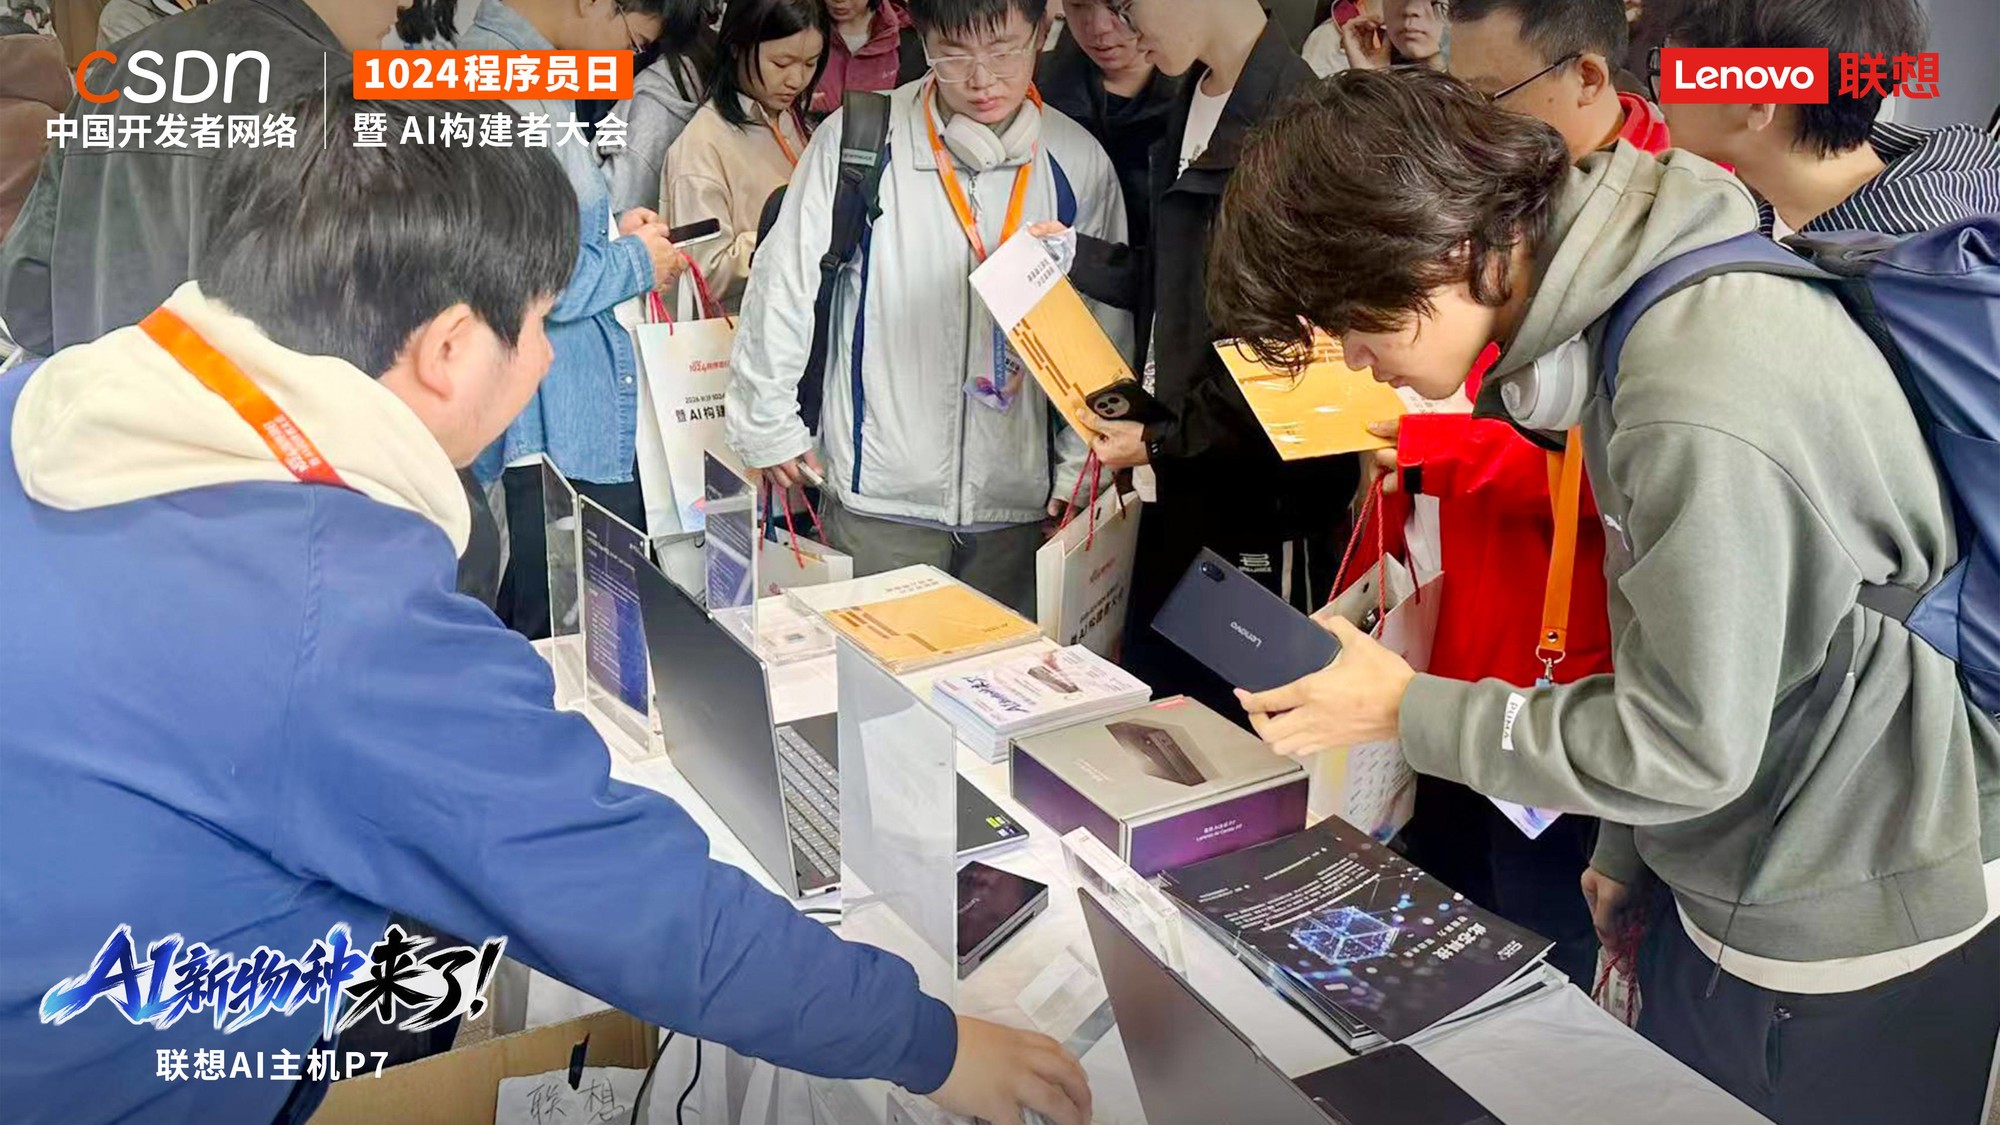
支撑这一切的是两颗国产芯片。后摩智能 M50 专攻端边侧推理,靠存算一体架构,以 10 瓦功耗输出 160 TOPS 算力,让整机控制在 300 克、手掌大小,还能长时间连续跑任务。此芯 P1 是智能体系统级芯片,6nm 制程,内含十二个 Armv9.2 核心,另配 30 TOPS 的神经网络单元,异构算力合计 45 TOPS,负责系统运行与调度;它支持外接不同规格的 AI 加速器,扩展后可承载 122B 模型、128K 上下文,出词速度能到到每秒 50 个词元。
双芯之上是联想的天行 AI 计算架构,从模型与算子优化、异构资源调度一路做到推理引擎。官方给出的量化数据是:混合精度量化下,四项基准的平均得分达到全精度基准模型的 98.3%。软件侧内置天禧 AI,开箱即用,也允许自行配置智能体;自动模式会按任务复杂度在本地与云端之间挑更经济的选项,用户也可直接指定本地模型对话,不消耗词元。
从形态看,P7 回答的是"个人 AI 算力该放在哪里"。云端便宜灵活,隐私与稳定性却受制于人;全本地安心,硬件成本与模型迭代压力又不小。混合调度把高频、敏感的推理留在本地,峰值需求交给云端——这个平衡点是否成立,先享计划那批用户的反馈,会比参数更有说服力。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复