10 月 2 日,英伟达正式公布 DGX Spark 的产品更新,带来 64GB 内存版本,起售价 4999 美元,将于 10 月 23 日开卖。宏碁、戴尔、华硕、技嘉、微星以及 H3C 等一批 OEM 厂商都会推出基于该平台的整机。
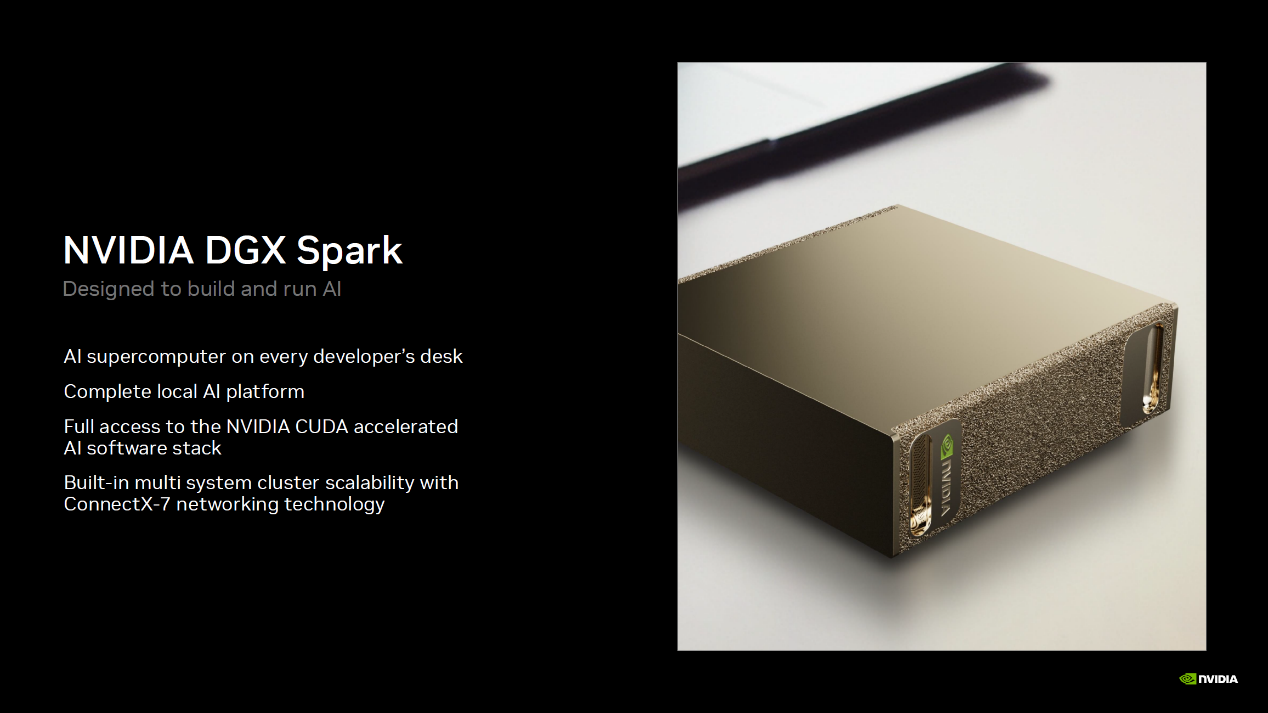
先前推出的 128GB 版本也同步调整了价格,其中 128GB FE 版定价 6950 美元。
硬件上,DGX Spark 的核心是 GB10 这颗 Grace Blackwell 超算芯片,靠统一内存架构打通处理器与显卡的内存空间。新增的 64GB 版本整机总内存 64GB,其中约 8GB 留给系统,能拿来放模型权重与 KV 缓存的显存约 56GB,还支持 NVFP4 这种量化格式,可顺畅跑起 Gemma4 的 26B 版本、Qwen3.8 的 27B 版本、Meta 的 Muse Glimmer 以及 Nemotron 家族的 3.5 Lightning 等一批主流开源模型,装好之后还剩内存余量去顶长上下文推理。
多机集群是它的一大亮点。设备内置 ConnectX 7 高速网卡,配上全新的 NVIDIA Sync 工具箱,开发者无需深厚网络功底就能搭起多节点集群;套件里的集群助手会自动完成网络配置、设备校验与 SSH 环境搭建,最多把 4 台 DGX Spark 串成一个集群。官方实测两台 64GB 机型组成集群运行 Qwen3.8 27B 模型,相比单台最高提升 1.7 倍,明显抬高推理吞吐。开发者还能从普通电脑远程接入集群,兼容 VS Code、Cursor 这一类主流编辑器,远程监控状态并一键启动 vLLM 推理容器。
软件生态是核心竞争力。整机把 CUDA 加速的 AI 软件栈配齐,对 vLLM、llama.cpp 等推理框架做了深度适配,还专门为本地智能体工作流调优,做本地智能体推理时最高能拿到 1.9 倍提速。Perplexity 已完成适配,让 Laguna S2.1 这款 118B 大模型能在本地跑起来;Nemotron 与 Gemma、Qwen,以及 DeepSeek 和 Mistral 这些开源模型与框架,都已经适配到位。
跑分方面,把 Qwen3.8 的 27B 版本放到 DGX Spark 上测试,评测分数距前沿闭源模型只差 10 分。作为合作方,Perplexity 方面评价称,该设备能近乎打满图形与内存负载,散热稳定,统一内存设计能让每瓦功耗换来的 Token 产出尽量接近上限,适合全天候跑本地智能体任务。
当然,整套方案仍面向专业开发者,4999 美元起的定价决定了目标人群是 AI 研究人员、独立开发者与小型创业团队。64GB 版本把采购门槛拉低后,更多团队也能把本地集群能力用起来。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复