10 月 1 日,美国的 AI 基础设施公司 Baseten 对外表示,其企业客户如今已经能在 OpenAI 的编程工具 Codex 里直接调用 Kimi K3。相关用量费用不单独结算,而是并入企业原来那份 OpenAI 采购承诺额度里,既省去了引入新供应商的流程,也免去了额外的合同审批。
这一步的意义在于,Kimi K3 就此用上了 OpenAI 面向企业客户的主流付费结算通道,成为第一个进入该体系的中国开源大模型。对国产大模型来说,这不仅是能力层面的认可,更意味着它冲破了自有生态的边界,开始融入全球主流开发工具链并走向规模化商用。在此之前,亚马逊云科技旗下的 Amazon Bedrock 平台早前就完成了 Kimi K3 的接入部署,两边走的是收入分成模式,这是中国大模型企业第一次以分润机制向国际头部云厂商输出核心模型能力。
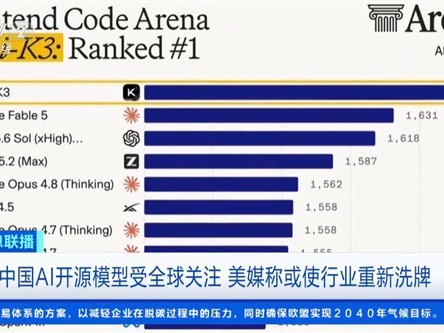
回溯产品本身,月之暗面在今年 7 月带来了 Kimi K3 这款新一代大模型,参数规模高达 2.8 万亿,发布时是全球参数量最大的开源模型;上线后几个小时之内,它就登上了业内权威的 AI 代码能力评测榜 Arena 的第一名,成为首个拿到这一成绩的中国大模型。它能原生理解多模态视觉内容,上下文窗口拉到了 100 万 Token,并在软件工程与深度学术研究、以及知识密集型工作和复杂多模态任务上都做了系统性优化,长文本建模和高阶推理能力都有明显增强。特斯拉首席执行官也在相关评测报道的评论区留下“Impressive”这样的评价。
更受关注的是,Kimi K3 还完成了一次概念验证——让 AI 自己去设计 AI 芯片。在一连 48 个小时的智能体运行测试里,模型借助开源的电子设计自动化工具,加上 Nangate 的 45 纳米工艺库,独自完成了从零到一的定制芯片设计,目标是给自家的轻量级 nano 模型做定制加速。
整个流程从架构怎么定、逻辑如何综合,到物理实现与反复迭代调优,再到功能验证,环环都自己走通。数据方面,这款芯片面积 4 平方毫米,内部集成了 146 万个标准单元,另带 0.277MB 的嵌入式 SRAM,采用把反量化融合进来的 INT4 乘累加阵列,在 100MHz 频率下达到完整的时序收敛,持续解码吞吐保持在每秒 8700 个 Token 以上。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复