AI 推理的瓶颈,越来越多地落在数据搬运上。高通十一月二日宣布,其第一代高带宽计算技术已在美国圣迭戈实验室完成硬件验证,完整的读写能力与近存计算能力都跑通了。
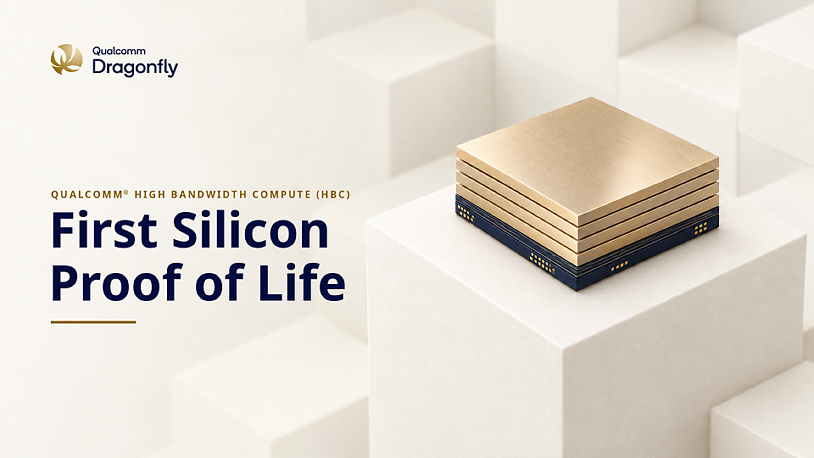
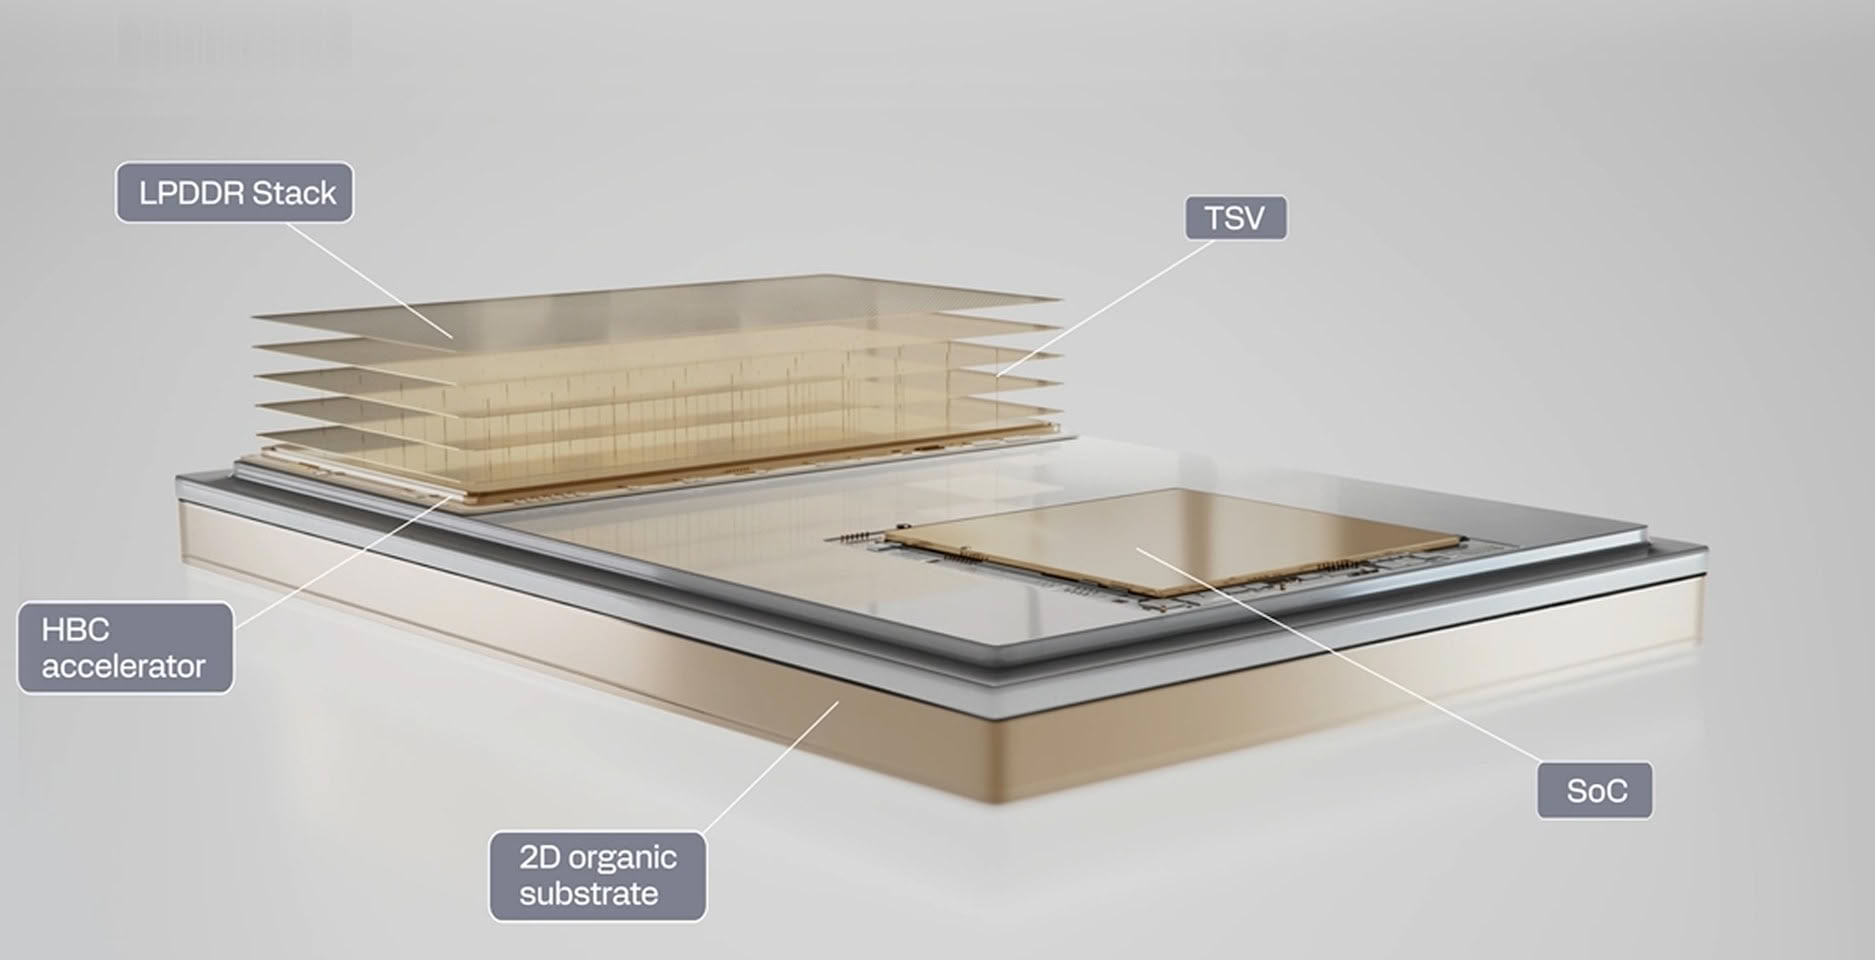
这套技术的思路与 HBM 不同。HBM 靠堆叠 DRAM 颗粒提升带宽,HBC 则是把多层 LPDDR 内存直接叠在计算芯片上方,通过硅通孔实现芯片间互连,堆叠结构底部放一颗负责近存计算的计算芯片。计算单元被挪到内存堆栈正下方,数据要走的距离从传统架构的数厘米缩短到数微米。
距离缩短带来的好处很直接:功耗下降、延迟降低。高通希望借助 LPDDR 本身的低功耗特性,加上计算与内存的紧耦合,改善推理场景下的数据搬运效率。其设定的目标是每瓦带宽要做到传统 HBM 方案的六倍。
验证用的是早期样品,采用两层 DRAM 堆叠。测试结果显示,每瓦带宽是 HBM4 的五倍以上,但还没到 6 倍的目标线。正式产品预计改用四层堆叠,届时这一指标有望补齐。
带宽数字更直观。第一代 HBC 会给 给 AI250 加速卡备了 133TB 每秒的有效带宽,对比用 LPDDR5X 的 的 AI200 提升 18 倍。这个跨度不是靠频率堆出来的,而是架构层面的变化。
产品节奏已经排好。搭载第一代 HBC 的 AI250 安排是 2027 年上半年拿出样品,意味着用 拿 LPDDR 顶替 HBM 的推理内存路线正式进入产品化阶段。按照高通在 2026 年 6 月给出的数据中心路线图,后续的 AI300 将采用第二代 HBC,有效内存带宽的设计目标是 AI200 的 54 倍。
为什么是推理而不是训练?训练对带宽与容量的要求极端,HBM 仍是主流;推理则更看重每瓦性能与成本,这正是 LPDDR 堆叠的用武之地。如果 HBC 能把每瓦带宽的优势兑现,数据中心的推理集群在同样的电力预算下就能跑更多任务。
当然,从实验室验证到量产卡还有距离:四层堆叠的良率、散热路径、封装成本,都是要过的关。AI250 明年上半年的出样表现,会是观察这套架构成色的第一个窗口。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复