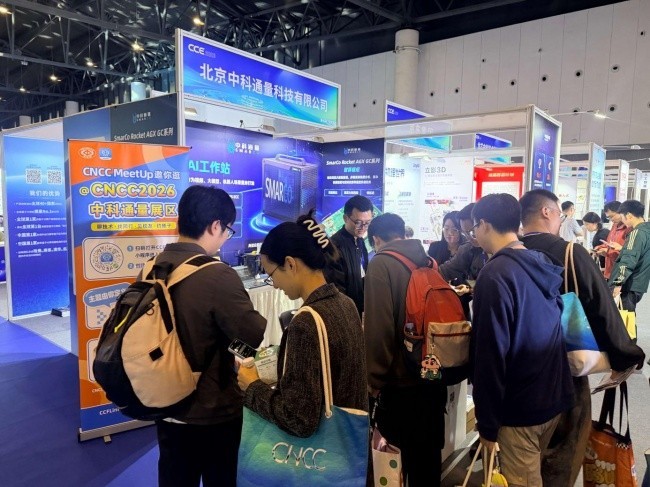
十月二十一日至二十四日,2026 中国计算机大会暨 CCF 计算机展览会在成都召开。中科通量把 SmarCo 系列产品带到现场,围绕大会主题"数聚驱动,智算未来",铺开了一套国产 RISC V 数据流智算矩阵。在十二位院士与众多国家级人才到场的高规格场合,这套从芯片一直做到边缘终端的展品,成了观察国产算力路线的一个切口。
这家公司的底子来自视频智能。核心团队在这一领域浸淫二十余年,在 GreenGraph 500 的大小数据集上拿过全球双冠军,专利授权累计一百四十余项,研发人员占比过半。它想做的事很明确:把软硬件全栈自主可控的智算底座做出来,为高并发数据场景提供低延迟算力。
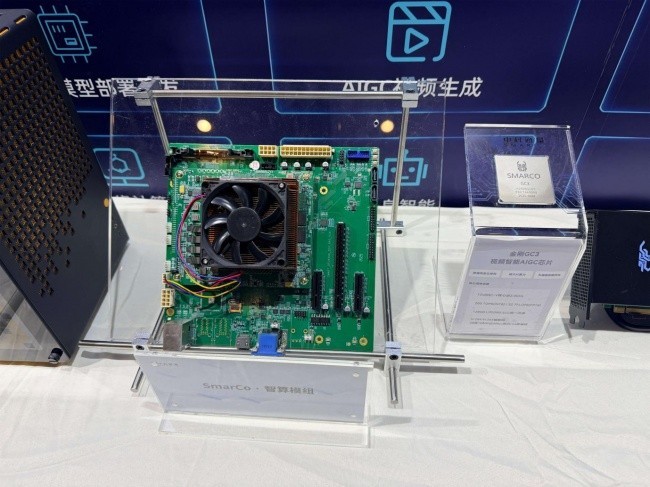
芯片与模组层面,现场主角有两个:SmarCo GC3 芯片,以及把算力封装成可部署形态的 Rocket AGX GC 模组。GC3 采用数据流原生架构,定位"为视频智能而生",在视频处理、大模型推理、边缘智能等负载中兼顾高并发与低延迟。模组则把芯片能力封装成可直接部署的形态,面向多路高清视频分析、机器视觉与实时决策等重活,强调能效比、算力利用率与接口兼容性。
桌面端是 SmarCo AI 工作站。它被定义为桌面级高性能智算终端,服务视频智能、大模型、机器人研发调试等场景:250 TOPS 的 INT8 算力,统一内存容量 128GB,规格为 LPDDR5 ECC,可实时硬解 128 路 1080P 高清视频,并集成十二个 RISC V 核心。官方强调"全接口开放,科研调试零门槛",现场技术人员实时跑了本地大模型推理与视频分析任务。
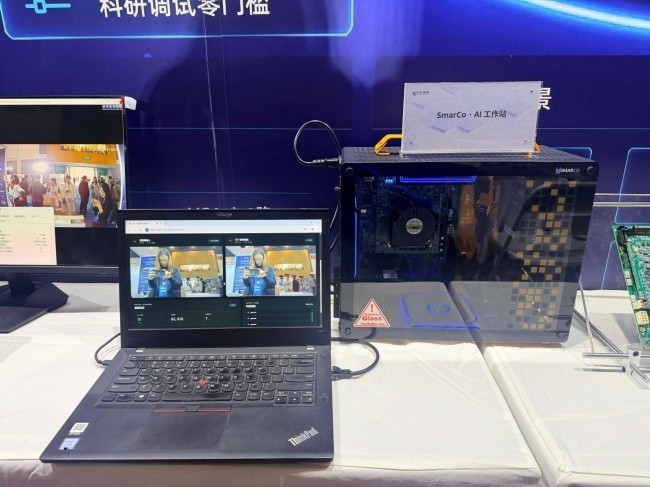
展台上另一款实时演示的产品是 AI 数字员工 Box,出自 SmarCo 之手。它定位轻量化边缘 AI 终端,核心目标写在口号里——让每一块存量屏幕变成智能服务入口。它的特性清单里有存量屏焕新、本地安全智能,也有主动感知即时服务和企业知识沉淀,落点包括通信营业厅、银行网点,以及汽车 4S 店、零售展点和服务柜台。相比云端方案,边缘终端在数据本地化、响应实时性与部署灵活性上更占优势。
从芯片、加速卡、模组,到工作站与边缘终端,中科通量摆出的是一条完整链路。当大模型、视频智能与具身智能加速落地,算力需求正从云端向边缘、向桌面延伸,谁能在不同场景里提供高效、安全、可控的算力,谁就握住了下一阶段的门票。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复