随着轻量化 AI 模型的快速迭代,算力巨头英伟达正在抓紧布局“个人本地 AI”赛道的一整套软硬件产品。英伟达周四发布公告称,NVIDIA RTX Spark 设备将于今年 10 月开始出货。这款紧凑型电脑的核心卖点正是英伟达的 N1X 芯片:为了能在本地跑 AI,芯片支持最高 128GB 的统一内存,搭载的 Blackwell GPU 能够提供最高每秒千万亿次浮点运算能力。
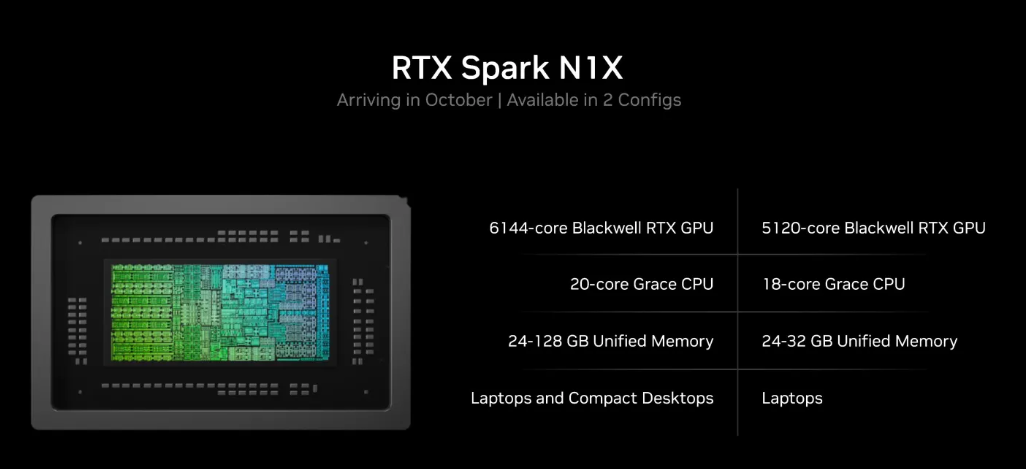
周四的最新消息也确认,N1X 芯片共有两个版本,核心差异依然是内存规格。“满血”版配备 6144 个 CUDA 核心的 Blackwell GPU 与 20 核 Grace CPU,支持 24GB 至 128GB 统一内存,用于超高端笔记本电脑和桌面紧凑型主机;另一版本的 GPU 核心降至 5120 个、CPU 核心降至 18 个,只支持 24GB 至 32GB 的统一内存——考虑到 32GB 显存只能跑动约 300 亿参数量的模型,这个版本更像传统游戏本的定位。目前 N1X 产品线的定价尚未公布,但鉴于存储涨价仍在持续,可以预期下个月上架的新一代 AI PC 价格不会便宜。
随着能在本地跑 AI 的设备越来越多,如何充分利用家庭算力也被英伟达提上日程。公司周四宣布推出开源个人 AI 路由器软件 NVIDIA PAIR(Personal AI Router),用来把家中多台电脑连接起来,协同处理本地 AI 推理任务。PAIR 可以自动发现同一网络中的兼容电脑,将这些设备连接成算力池。目前兼容设备主要包括搭载英伟达显卡的电脑(RTX 20 系列及之后的显卡,以及 RTX Pro GPU 和 DGX Spark 系统),搭载苹果 M4 或更新芯片的设备也可以使用——英伟达借此把苹果算力设备也拉进了自己的体系。
这款应用的关键设计在于:它会优先利用家中设备的空闲算力,尽量避免影响设备正在执行的其他任务,并能够随设备加入或离开网络自动调整资源。例如,当用户开始在台式机上玩游戏时,PAIR 会相应减少甚至停止调用这台电脑的算力。在媒体简报会上,英伟达产品经理塞斯·施奈德描绘了这样一个场景:父亲拥有一台 RTX Spark 笔记本和一台 DGX Spark 台式机,母亲使用 RTX 5090 笔记本,女儿有游戏台式机,儿子用 MacBook Pro——这个家庭拥有大约 165 万亿次浮点运算每秒(165 TFLOPS)的未充分利用算力。“如今散落在千家万户里的这些闲置算力,实际上就是一座免费的词元宝库。”
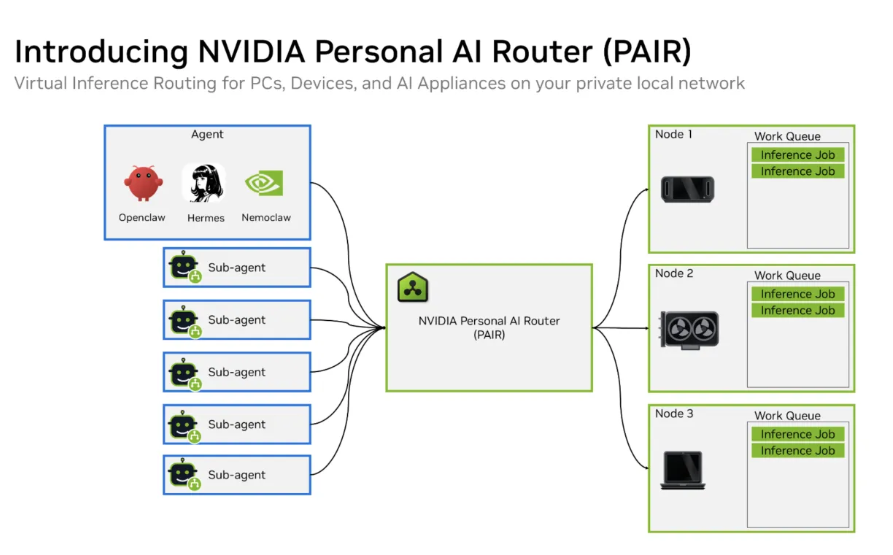
演示测试中,使用千问 3.6 35B A3B 模型时,如果仅在一台 RTX Spark 笔记本上运行,完成一项智能体任务平均需要 18 分钟;而由一台 RTX Spark 笔记本、一台 DGX Spark 和一台 RTX 5090 设备组成的三设备 PAIR 集群,平均仅需 8 分 48 秒,耗时缩短约一半。除了 PAIR,英伟达还宣布三款主要 AI 智能体应用(Perplexity Portable Computer、Hermes Agent 和 OpenClaw)将获得更简化的本地部署方式,新的安装体验让用户只需点击几下,就能在本地完成 AI 智能体的部署并启动运行。
从专用芯片到整机设备,再到盘活闲置算力的软件生态,英伟达正在把“本地 AI”从概念变成一套完整的落地方案。随着 10 月 RTX Spark 上市,个人算力市场的竞争也将进入新阶段。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复