一个美国政府网站,曾把中国公司的大模型放进搜索框。据路透社报道,美国政府的一个网站采用了中国企业的 AI 模型,供用户搜索拟议中的联邦法规。
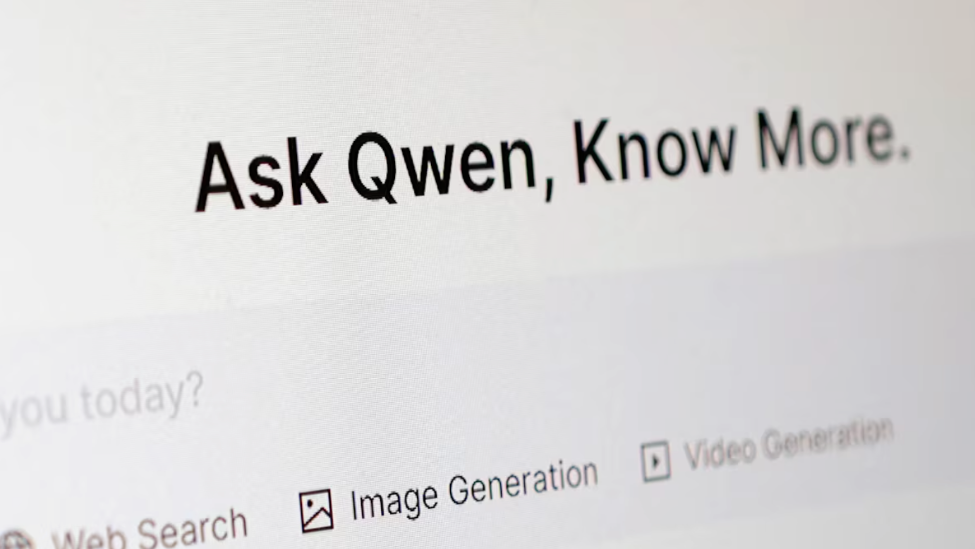
运营该网站的是美国国家档案馆。按照报道,周三那天,网站在原有搜索入口之外,还挂出了一个由阿里千问模型驱动的检索工具。该工具是何时部署的目前并不清楚。路透社查阅的截图以及该网站源代码的历史存档显示,这款以千问为底座的搜索工具在周三下线,大约同一时间,社交媒体上开始出现关于这个工具的帖子。
《联邦公报》网站的日常工作是每天发布新提出的拟议法规清单,并提供工具供公众浏览评论。把大模型接入法规检索,本质上是想解决长文档搜索与摘要的效率问题,这在各国政府数字服务里都是常见需求。
专家的看法相对克制。有受访专家认为,把这款来自中国的工具用在《联邦公报》上,未必会构成国家安全风险。千问属于开放权重模型,关键组件可以公开拿到,开发者能下载之后按需修改,成本通常也比 Anthropic、OpenAI 这一类闭源模型更低。也正是开放权重与低成本的组合,让这类模型在预算有限、需要快速部署的场景里具备吸引力。
截至发稿,美国国家档案馆以及白宫都没有回应置评请求。这次短暂上线与下线,暴露出的其实是公共服务机构在模型选型上的现实矛盾:闭源方案性能与合规信息更透明,成本却更高;开放权重方案便宜且可自控,但来源往往更敏感。
从技术选型角度看,政务网站接入大模型通常为了解决两类问题:一是把冗长的法规文本压缩成可读摘要,二是让公众用自然语言就能定位到具体条款。开放权重模型在这类场景里具有成本与可控性优势,机构可以自行部署、自行微调,数据也不必离开自有环境。这也是近期不少公共部门在模型选择上开始考虑开源方案的原因。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复