AMD 显卡跑不了 CUDA 程序,这条长期存在的"潜规则"可能要被撬动了。2026 年 9 月 15 日,一位独立开发者把 CUDA for AMD Windows 项目开源,第一次让 AMD 显卡在 Windows 上原生跑起原本只认 CUDA 的工作负载,整个过程不需要虚拟机,也不需要双系统。
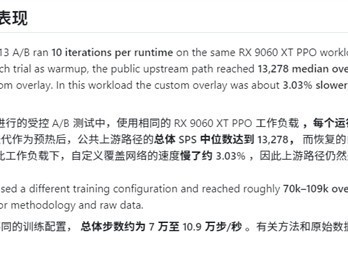
实测表现很有说服力:在一块 RX 9060 XT 上,项目跑通了 220 万参数的 PPO 强化学习训练,而全程调用的接口都是未经改动的标准 CUDA 库。
实现思路上,项目其实是一整套自动化 PowerShell 脚本:把 ZLUDA 翻译层,与 AMD 为 Windows 准备的 HIP、ROCm 开发套件深度对接。脚本会自行识别当前 GPU 架构,挑出合适的 ZLUDA 预发布版本并从网上取回部署,同时把它底层的数学运算能力映射到系统里已安装的 ROCm 基础库上。
关键的 CUDA 驱动 API,以及 cuBLAS、cuSPARSE 与 cuFFT 这三套核心数学库,都会被拦截并改送到 AMD 侧的 HIP 实现,从接口层面实现无缝兼容。
背景是,随着 ROCm 生态持续更新,Windows 上的消费级显卡如今已得到 PyTorch 框架和 HIP SDK 的官方支持,RX 7000、RX 9000 两代产品都包含在内。但大量行业专用软件、历史遗留代码和定制化 AI 工具仍严格依赖 CUDA,AMD 用户过去只能靠 WSL2 透传,或者等开发者把程序移植到 HIP。这个项目恰好补上了这段断点,相当于给只认 CUDA 的软件提供了一层即插即用的适配。
性能方面,在 RX 9060 XT 上跑同一套 220 万参数强化学习任务时,官方 ZLUDA 搭配 AMD HIP SDK 6.4 的组合路径平均吞吐量为 13278 steps/秒;换成从旧版 ZLUDA 二进制里提取并优化过的自定义覆盖层,数值为 12876 steps/秒,两者差距约 3%。开发者提到,在把 LibTorch 和 ZLUDA 的依赖剥离之后,吞吐量明显上升,说明当前翻译层仍存在一定运行开销。
需要说明的是,cuDNN、TensorRT、NCCL 这些 CUDA 生态的核心组件暂未被该项目覆盖。如果目标程序深度绑定 cuDNN 等闭源库,这套方案无法生效。但它的价值在于证明:AMD 显卡跑 CUDA 专属软件,障碍并非硬件层面的不可逾越,而是可以由软件翻译层解决的兼容问题。项目全程开源,社区协作有望把支持范围扩展到更多 GPU 型号与功能模块。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复