一篇发布于 ChinaXiv 的预印本论文近日对外公开,华为工程师何庭波详细披露了韬定律的底层原理,并放出麒麟 2026 芯片的实测数据。长久以来行业普遍认为 3D 堆叠会带来严重的发热难题,但麒麟 2026 的实测结果给出了完全不一样的答案。
传统摩尔定律依靠缩小晶体管几何尺寸实现性能迭代,而受外部条件限制,华为无法继续沿用 EUV 极紫外光刻向下推进制程。华为选择跳出空间缩放的固有路线,开创韬缩放定律,不再一味缩小晶体管,转而压缩信号在芯片内部传输的特征延迟,其核心落地技术正是逻辑折叠。逻辑折叠依托 3D 混合键合工艺,把原本平铺在平面的电路拆分为多层垂直堆叠的硅片裸片,依靠微米级垂直互连桥接各层电路,将芯片内部漫长的水平走线替换成距离极短的垂直跳转。麒麟 2026 实现了 1.5 微米键合节距,拥有 5000 万根垂直互连;下一代麒麟 2027 已达成 1 微米键合节距,垂直互连数量突破 1 亿根。
麒麟 2026 是首款落地逻辑折叠的移动 SoC,单代迭代之下,晶体管密度从 1.55 亿每平方毫米提升至 2.38 亿每平方毫米,增幅达到 55%,相当于过去三年依靠传统工艺微缩取得的全部成果。
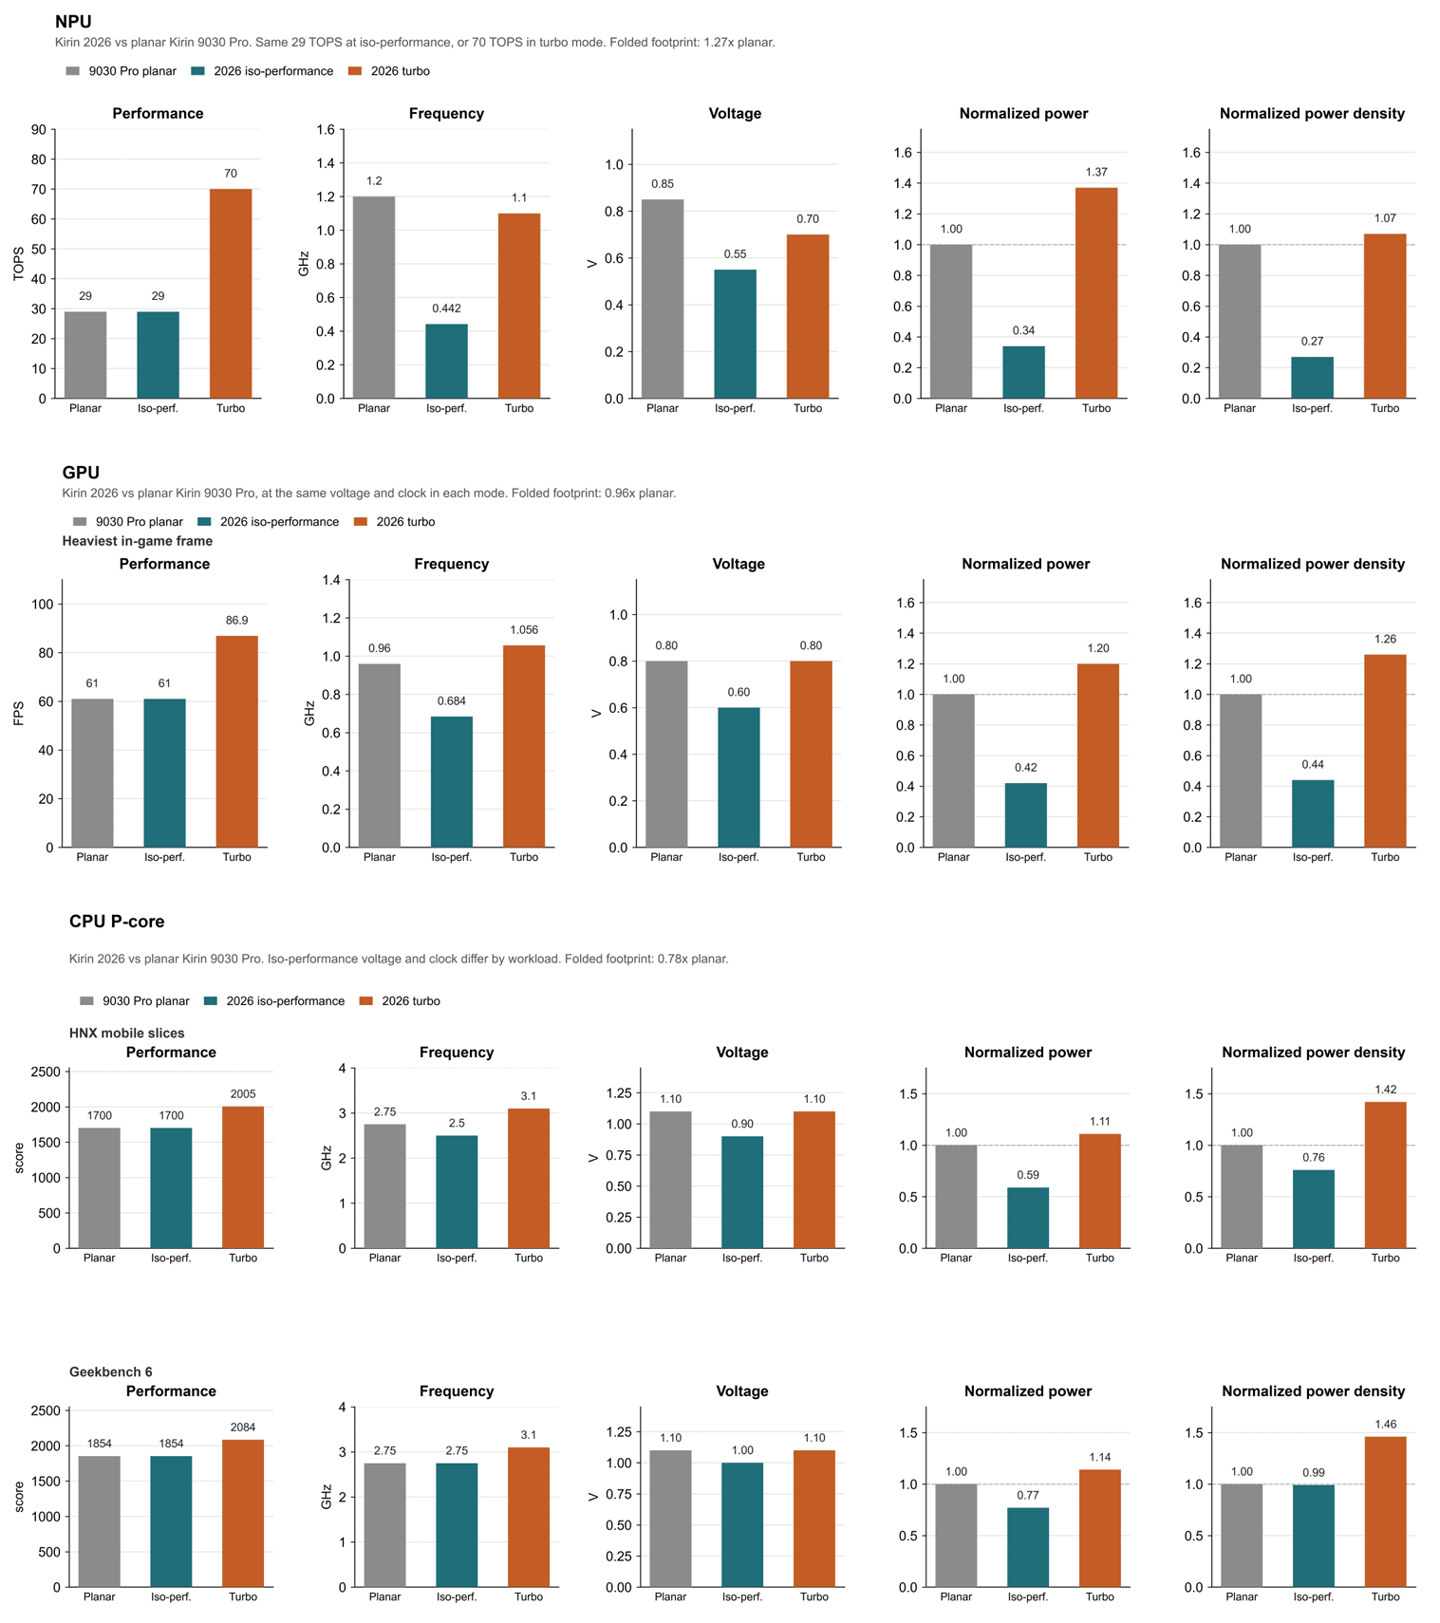
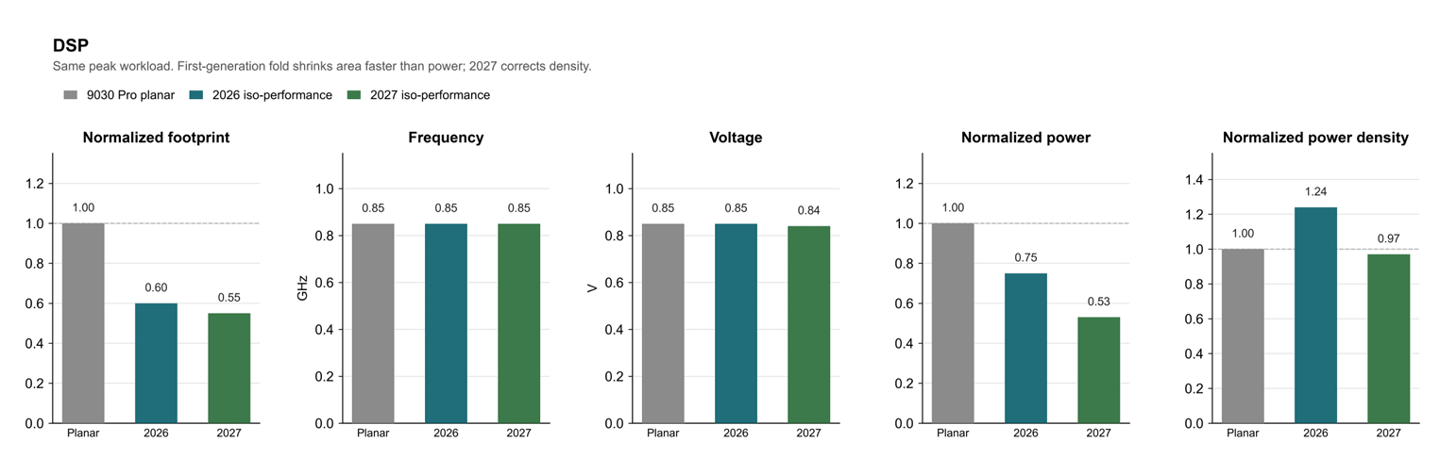
按照行业固有认知,晶体管密度大幅提升,功率密度与芯片温度必然随之飙升,但实测结果截然相反。在同等性能的测试条件下,对比前代平面架构麒麟 9030 Pro,麒麟 2026 的 NPU 功耗下降 66%,GPU 功耗下降 58%,CPU 性能大核功耗下降 41%,完成同等工作时芯片温度反而更低。论文解释了这一反常识现象的核心原因:芯片绝大部分能耗并非消耗在晶体管本身的计算上,而是消耗在金属走线的数据搬运。逻辑折叠大幅缩短信号走线长度,直接削减占据功耗大头的互连电容开销,同时走线变短后电路可进一步降低工作电压,而动态功耗与电压平方成正比,由此带来幅度更大的功耗收益。
从各模块实测数据看,数据搬运越密集、并行度越高的模块,逻辑折叠收益越显著。作为 AI 算力核心的 NPU,保持 29 TOPS 算力不变,频率降低 63%,电压从 0.85V 降至 0.55V,功率密度暴跌 73%。CPU 大核因存在大量不可并行的串行计算任务,功耗收益相对有限,仅取得 41% 的功耗降低,麒麟 2026 已实现 3.1GHz 大核频率,未来数年内目标是把 CPU 核心频率推向 5GHz 以上。
逻辑折叠还给芯片带来双重工作模式:除了等性能下的省电低温,开启涡轮增压模式时,麒麟 2026 的 NPU 算力可达 70 TOPS,相比前代提升 141%,GPU 帧率提升 42%,系统可根据场景在极致省电与极限性能之间灵活切换。热设计上,华为采用选择性折叠与热感知布局,交错排布高低温逻辑模块,避免热点上下层直接叠加,让热量多层分摊并优先横向扩散,把晶体管结温控制在安全区间。从实测结果来看,功率密度并非堆叠技术的宿命,而是可以通过设计精细调控的结果。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复