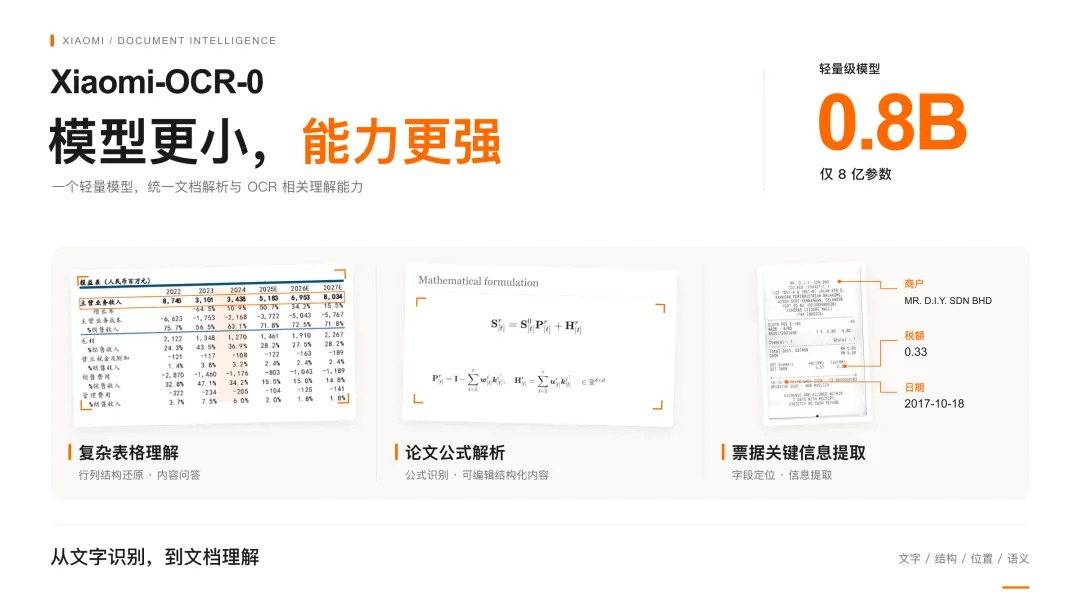
小米在 10 月 30 日放出了一个只有 0.8B 参数的文档理解模型,取名 Xiaomi OCR 0,权重与推理代码同时放上了开源社区。官方的说法是,这一个模型要同时应付版面解析、字段抽取和针对图文的问答。
解析能力覆盖正文、表格和数学公式,输出时按照人的阅读顺序组织,格式上原生给出 Markdown 与 LaTeX。字段抽取则瞄准发票、收据、卡证与业务表单,用户指定需要哪些字段,模型定位后直接吐 JSON,方便接进自动化流水线。
问答能力不只做文字转写。它可以跨区域检索文档与图表里的内容,做数值计算,也能就语义做推理。
底座选的是通义千问 3.5 的 0.8B 基础版,训练喂了 1.7 亿条样本,OCR 与文档理解都包含在内。标注环节引入多个 OCR 专家模型交叉校验,用投票筛出置信度高的结果,避免单一模型把错标当正解。
复杂表格和公式是这类模型最容易翻车的地方。团队的做法是把候选解析结果重新渲染成图片,再跟原始区域比像素、比结构,一旦发现行列错位或符号丢了,就回到对应位置修正。训练数据里还合成了大量困难样本,覆盖多语种、古籍手写、屏幕摩尔纹和扭曲光照。
训练分三步走。第一步用 Q Mask 把视觉局部区域和文字单元在空间上对齐;第二步做 OCR 持续预训练,用百亿级的多任务混合数据打底;第三步是混合任务强化学习,奖励信号取自结构编辑距离、表格匹配程度、问答正确率。
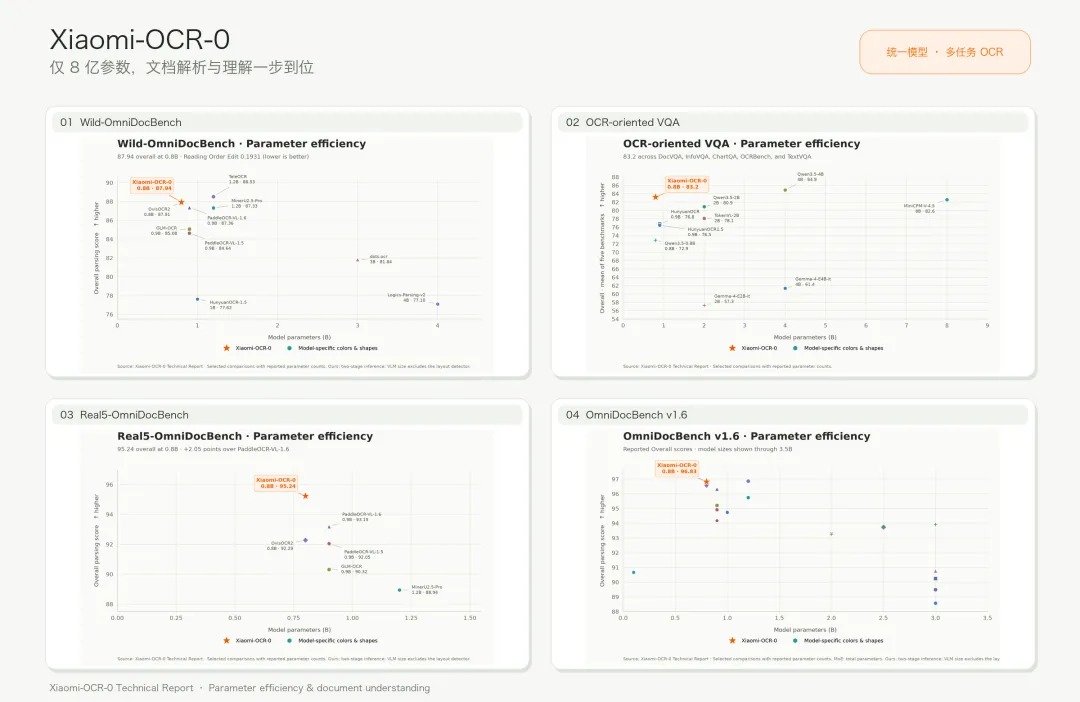
成绩单比较亮眼。Real5 OmniDocBench 模拟扫描件、弯折的纸、翻拍的屏幕、变化的光线与倾斜角度五种采集方式,这个模型拿到 95.24 分,在参评模型里排第一;Wild OmniDocBench 上得 87.94 分。再看综合基准的 1.6 版榜单,它以 96.83 分位居第二,距榜首 0.04 分,在 1B 以下参数组里是第一。
专项测试中,数学公式基准 UniMER Test 得 97.84 分,表格结构基准 PubTabNet 得 92.27 分;古籍与书法测试集 Chronicles OCR 上,它得到 73 分;闭源模型 Seed 2.0 Pro 同期为 72 分,两者基本齐平。
在文档问答、信息抽取问答、图表问答、OCR 综合与文本问答五个基准上取平均,该模型为 83.2 分。官方给出的对比里,混元 OCR 1.5 是 76.5 分,TokenVL 2B 是 78.1 分,TextHawk2 是 78.5 分;通用多模态这边,通义千问 3.5 的 2B 版本 80.9 分,8B 的 MiniCPM V 4.5 为 82.6 分,4B 版本的通义千问 3.5 则到 84.9 分。
手机上已经能看到落地形态。超级小爱支持短按 AI 键、三指上滑或语音唤起,把屏幕里的取餐码、取件码与排号提取出来放在显眼位置。账单和卡证场景能读出交易金额、商户、付款时间以及消费分类,交给智能记账;发票、身份证、银行卡拍一张就完成字段提取。群聊里的会议通知或海报上的时间地点,也能被识别成日程卡片。
配套工具包括浏览器里的交互式演示、MCP 服务和 Agent Skill 工具集,第三方可以按自己的业务流程接入。0.8B 的体量让端侧部署不再是难题,这也是小参数文档模型最近被反复讨论的原因。
文章与图片内容转载网络,如有侵权请联系平台删除
发表评论 取消回复