亚马逊这支名为 Strands Agents 的团队在当地时间本月 1 日宣布,推出名为 Strands Decider 2B 的决策模型。该模型已在 GitHub 上开源,权重可以到 Hugging Face 上取,并且支持在本地 CPU 或 GPU 上运行。
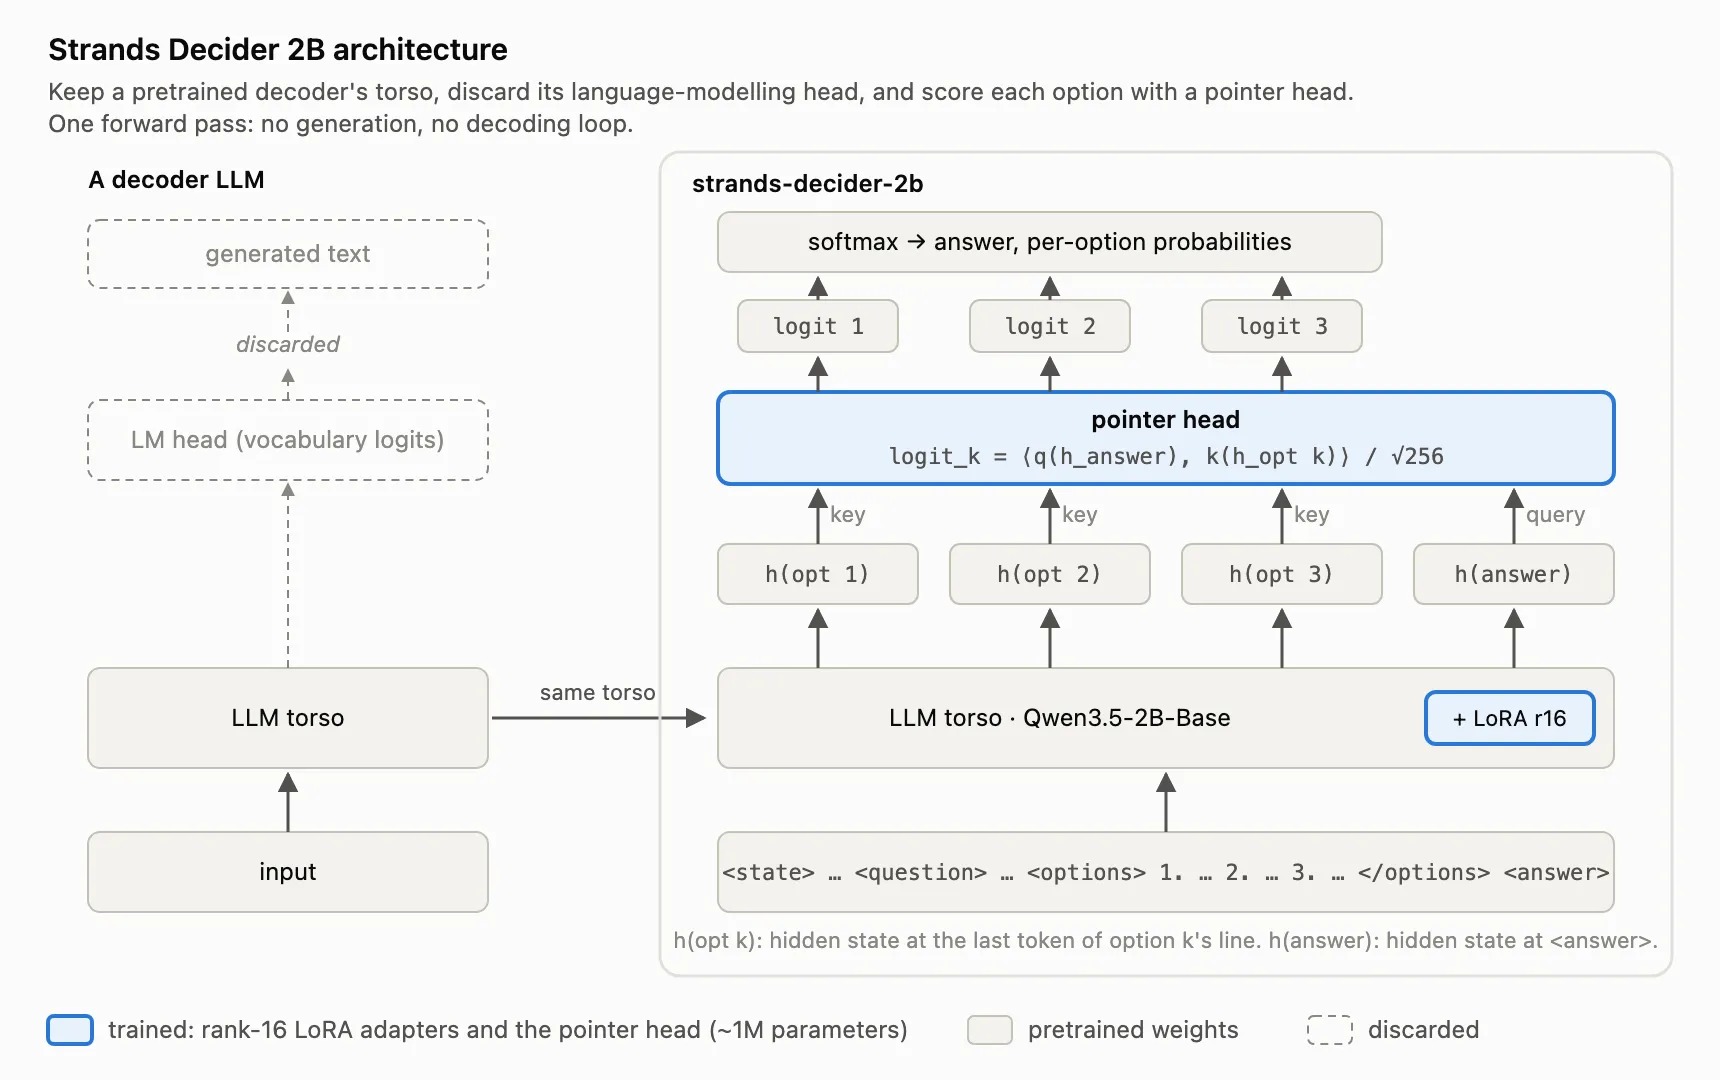
从结构上看,Strands Decider 2B 的做法颇具巧思:它以预训练的 Qwen3.5 2B 作为"躯干",再用一个具备评分功能的指针式"头部",替换掉原本负责文本生成的语言模型"头部"。新"头部"的规模很小,总参数仅略超过一百万;而"躯干"则通过一个 rank 16 LoRA 适配器完成微调。
性能表现上,该模型在 JevBench 公开数据集上展现出不错的准确率与校准度,在 2B 这一档里排到第 3,强于所有不超过 2B 的对手。
落地效率是它的另一看点。在市面常见硬件上本地运行时,它的决策时延中位数只有 113ms;即便放到英伟达的 RTX 3090 上跑小型决策任务,中位时延也只有 153ms。
对开发者而言,一个可本地部署、时延可控的小体量决策模型,意味着在智能体编排、工具调用选择等环节多了更轻量的选项。与动辄数十亿参数的大模型相比,2B 级别的决策专用模型更看重响应速度与部署成本,而不是泛化的生成能力。亚马逊把权重放到开源社区,也让这类模型的二次开发门槛进一步降低。
从更宏观的角度看,推理成本正在成为智能体大规模落地的现实门槛。把决策这类高频、轻量的环节下沉到小模型,与其说是技术炫技,不如说是一种务实的工程取舍;未来类似的"大小模型协同"分工,或许会越来越常见。
从趋势上看,大模型负责理解与生成、小模型负责即时决策的分工正在变得清晰。把"决策"这一环节交给更小、更快、更省算力的专用模型,既能压低推理成本,也便于在隐私敏感或离线场景中本地部署。亚马逊此番开源的思路,正是这一方向的一次具体落地。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复