Cactus Compute 的开发者带来了一款轻量 AI 模型,名叫 Needle 2,体积只有 14MB,专门针对树莓派 5 的处理器做优化,无需额外的 AI 加速扩展板,就能把自然语言指令实时翻译成预设的函数调用。
按树莓派官方的说法,Needle 2 并不是常见的通用聊天机器人,而是一款专注设备端指令执行的专用模型。用户输入点亮 LED 灯之类的话,它从识别到执行只要 78 毫秒,几乎可称即时响应。
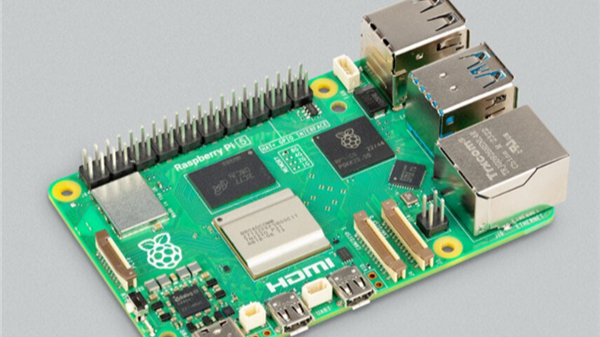
效率是它的卖点。在树莓派 5(8GB 内存版)实测中,模型运行占用内存仅约 28MB,就算把完整的 Python 演示程序一并跑起来,整体内存占用也只有 46.4MB。如此轻量,意味着它可以完全离开云端 API 与网络,在边缘侧完成纯本地的智能控制。
在与硬件对接的环节,Needle 2 通过与硬件绑定的 Python 标注机制实现对接:开发者只要在已有函数上加几处标记,模型便会自动读取函数名、说明与参数类型,进而生成调用规范。比如查询处理器温度的指令,响应时间 149 毫秒,会准确返回摄氏度数值,全过程都在本地处理器内完成。
它在逻辑判断上也颇为克制:碰到匹配不到预设函数的无关问题,它会在 92 毫秒内返回空值,而不是硬凑答案。这种宁可留白、也不乱答的做法,正好贴合设备控制这类容错率偏低的场景。眼下,Needle 2 的权重已经放在 Hugging Face 上,代码则以 Apache 2.0 协议托管在 GitHub,这意味着开发者可以直接在本地硬件上复现并二次开发。
从趋势看,把大模型能力拆解到具体任务、再下沉到低成本硬件,正成为边缘 AI 的一条现实路径。并非所有场景都需要全能型模型,像设备控制这样目标明确的任务,用更小、更快、更省资源的专用模型反而更合适,也更能兼顾隐私与稳定性。
文章与图片内容转载网络,如有侵权请联系平台删除

发表评论 取消回复